Publicado en nicolasbillia.com — Octubre 2026 · Serie brightonSEO San Diego 2026
Disclaimer
Este contenido fue escrito con ayuda de IA a partir de mis desgrabaciones y fotos de las charlas de brightonSEO + Hero Conf San Diego (15 y 16 de septiembre de 2026) y de datos de proyectos de Nomadic. Los datos del evento llevan el nombre de quien los presentó; los de clientes van sin nombre y por rubro. Las fotos de las slides son mías.
En corto
- El volumen de búsqueda mide bien la demanda cabeza. Para el resto, la herramienta agrupa variantes y redondea los mínimos.
- En el blog de un cliente fintech de hipotecas, 45,3% de las queries con impresiones en Search Console quedaban afuera de un filtro de “volumen mínimo 10”, y traían 1 de cada 3 clicks.
- Michael Louderback (ROAST) arma el keyword research por perfil de comprador y pone el volumen al lado de impresiones, clicks y quién rankea, no por encima.
- Andy Crestodina (Orbit Media) saca las preguntas de los prospects de las grabaciones de ventas: en 91 llamadas, SEO aparece en 16.
¿Por qué el volumen de búsqueda no alcanza para medir la demanda?
Michael Louderback, de ROAST, dio el martes 15 la charla “Keyword Research in the Age of AI”. Una de sus primeras slides tenía cuatro desigualdades: rankings no es visibilidad total, tráfico no es influencia total, impresiones no es descubrimiento total y volumen de búsqueda no es demanda total.
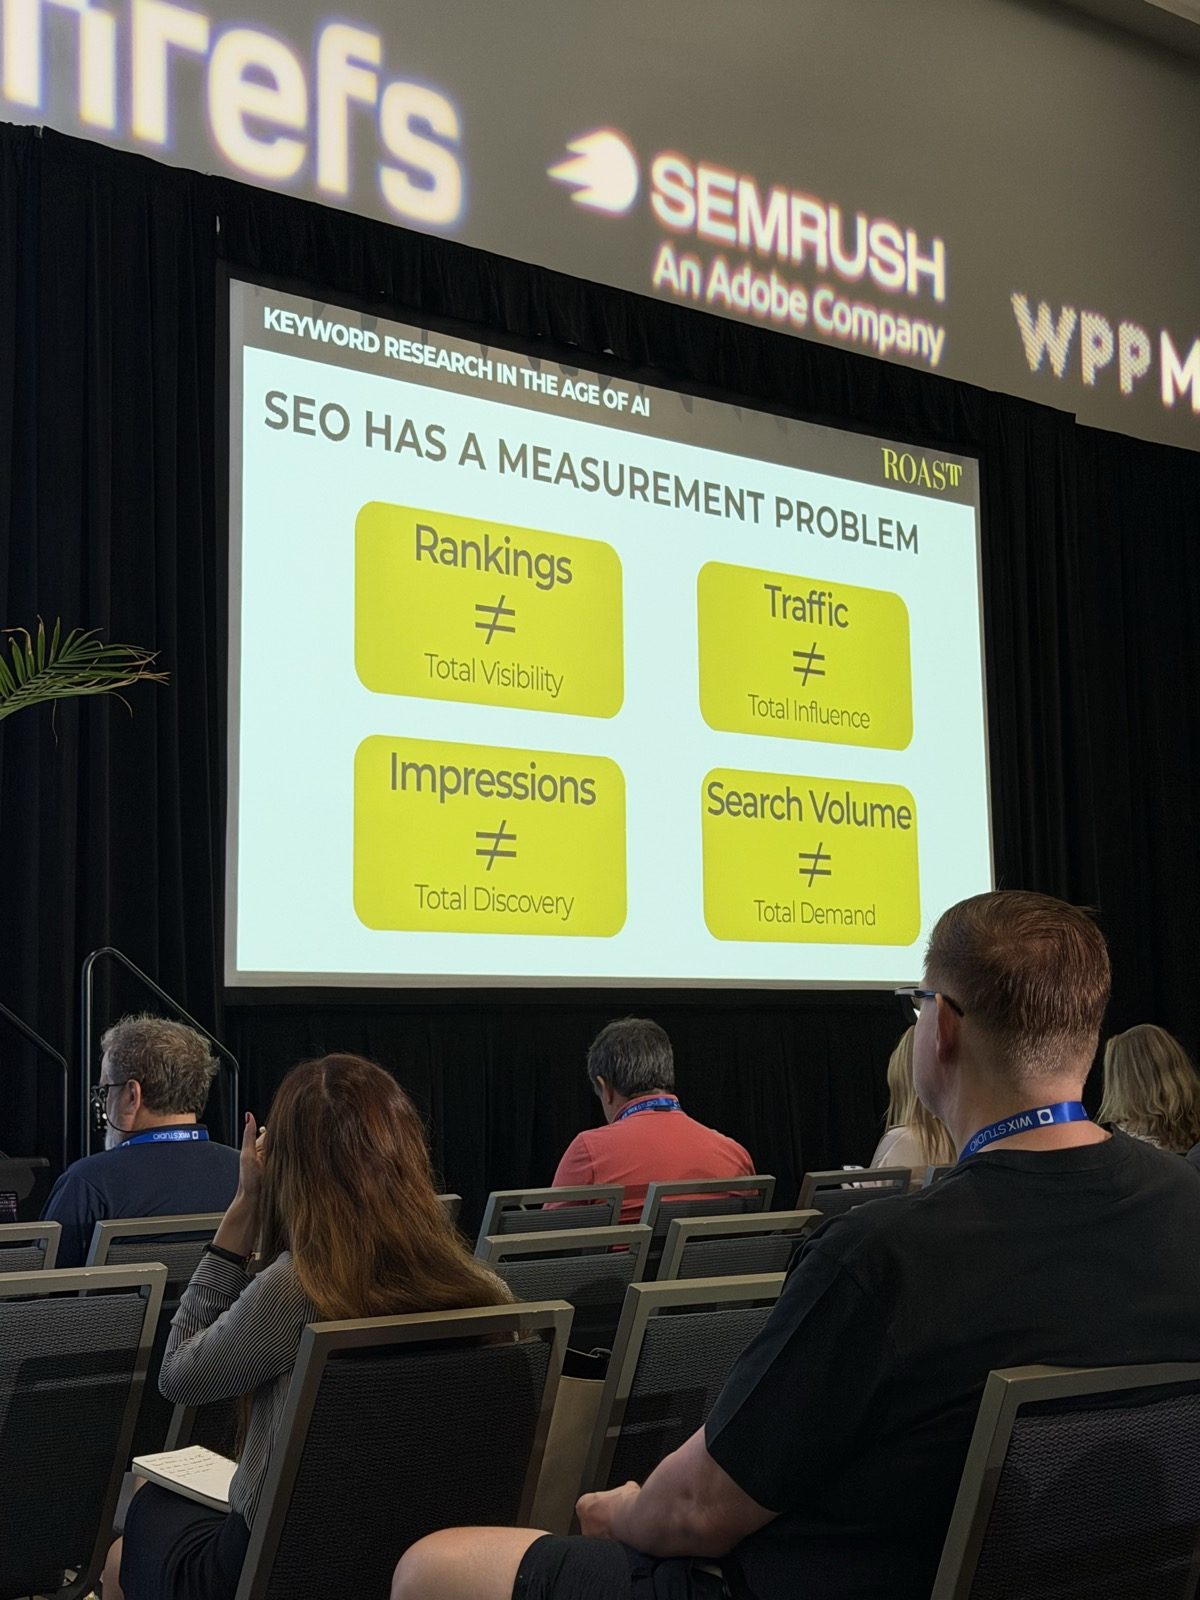
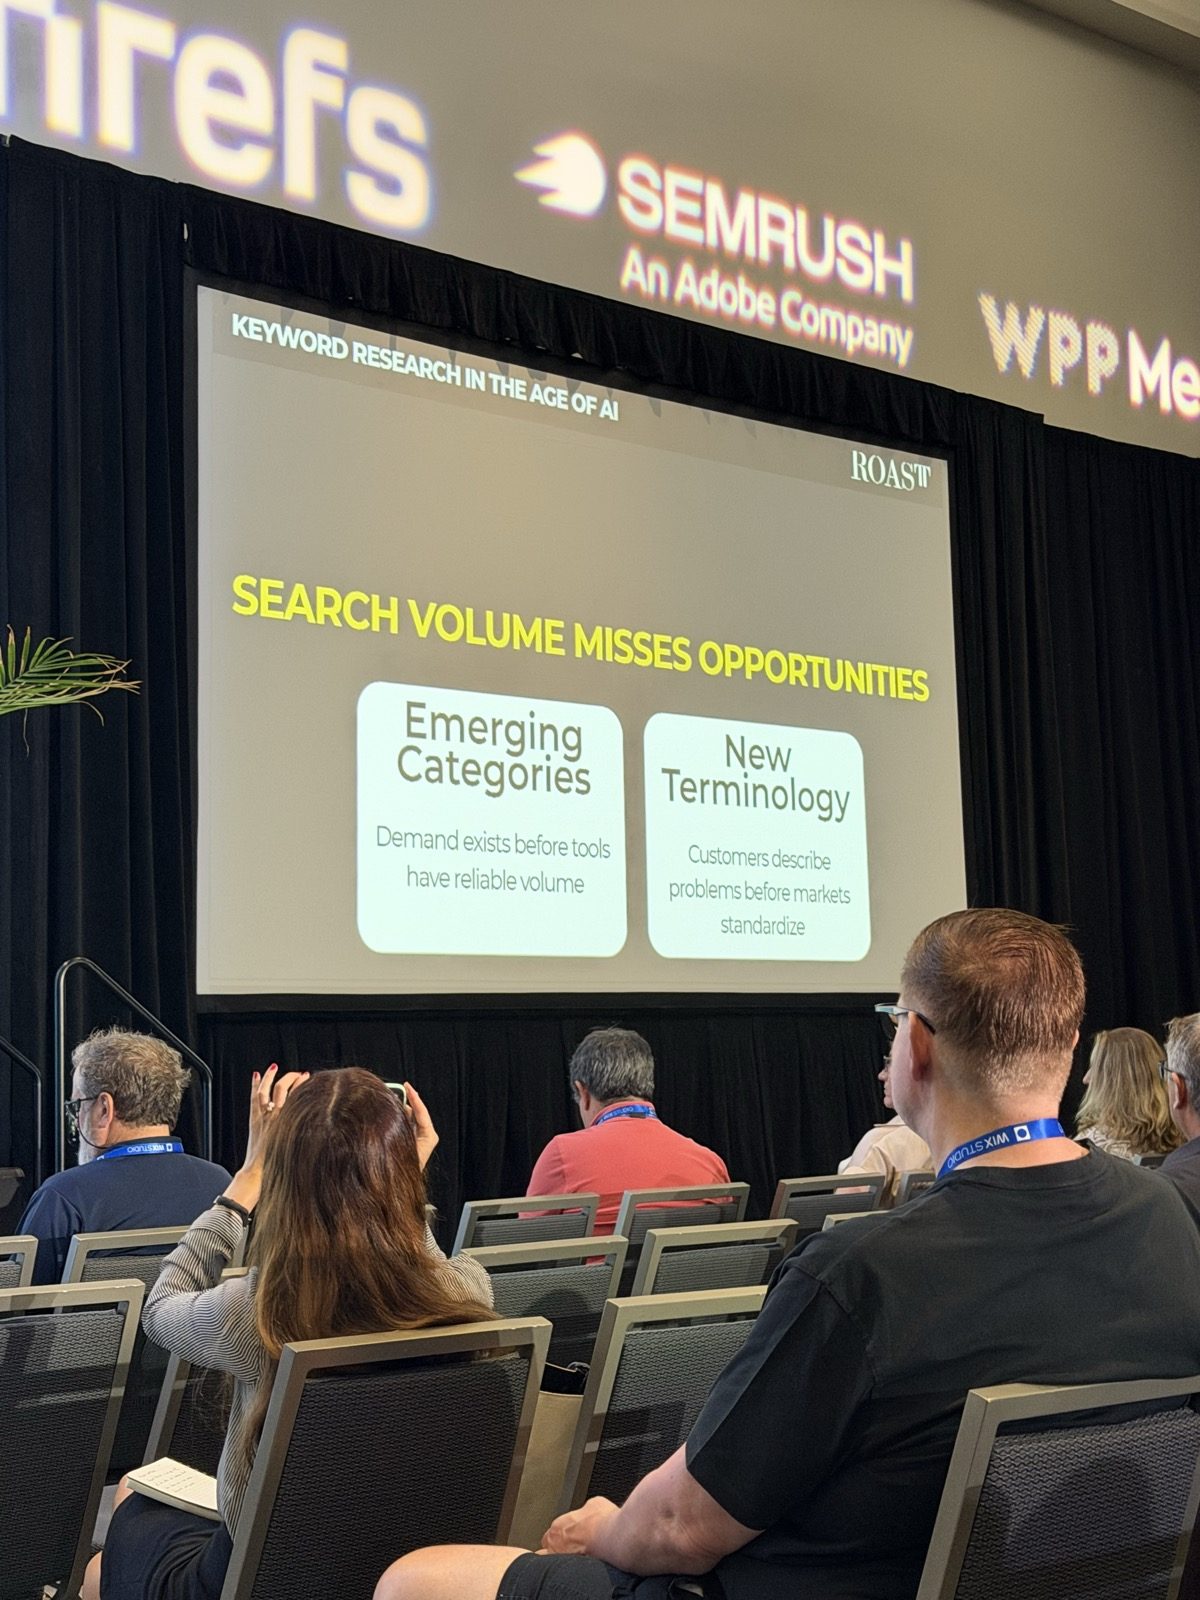
No dijo que el volumen no sirva. Dijo que sigue siendo una métrica proxy, igual que las de Search Console, y que hay que seguir usándolas. Lo que marcó son dos lugares donde falla por diseño: en las categorías emergentes, porque “la demanda existe antes de que las herramientas tengan volumen confiable”, y en la terminología nueva, porque “los clientes describen el problema antes de que el mercado lo estandarice”.
A eso le sumo lo que vemos con el planner de Google Ads: agrupa variantes bajo un mismo número y redondea los mínimos. Para la demanda cabeza es la herramienta correcta. El problema es usarlo como única fuente del mapa.
¿Cuánta demanda real queda afuera de un keyword research por volumen?
Lo medimos haciendo el ejercicio al revés: en vez de ir del planner al contenido, fuimos del contenido al planner. Tomamos 12 meses de Search Console del blog de un cliente fintech de hipotecas para extranjeros, sin queries de marca, y los cruzamos contra el volumen de Google Ads en tres mercados: Reino Unido, Estados Unidos y Australia. Quedaron 14.234 queries con impresiones.
| Corte | Queries | Impresiones | Clicks |
|---|---|---|---|
| Fuera del radar de un filtro “volumen ≥ 10” | 45,3% | 23,0% | 32,6% |
| Sin dato en el planner (volumen 0, nulo o keyword que no acepta) | 17,4% | 11,1% | — |
En el segmento fuera del radar el sitio rankeaba en posición ponderada 16,6, contra 33,3 en las keywords que un keyword research tradicional habría elegido. El CTR era 0,142% contra 0,087%. Esa diferencia de CTR la explica la posición, no la query: hay menos competencia porque esas búsquedas no están en la planilla de nadie.
Dos datos más del mismo cruce. El 49,7% de las queries fuera del radar correspondía a dolores que ya habíamos visto en Reddit o en el CRM del cliente antes de cruzar nada. Y 64% de las impresiones del blog venía de queries que Search Console ni siquiera muestra, por anonimización.
La aclaración: es un blog de nicho, en inglés, con unas 860.000 impresiones al año, y las queries de países fuera de esos tres mercados quedaron afuera del cálculo. No traslado el 45,3% a otro sitio. Lo que se repite de un sitio a otro es el mecanismo, no el número.
¿Cómo se ordena la demanda si el volumen no es el eje?
Louderback propone cambiar la unidad de análisis: del keyword al perfil de comprador. El proceso que mostró, con un ejemplo de viajes, arranca antes de bajar datos: armar el perfil y escribir a mano qué buscaría y qué preguntaría esa persona. Después se baja todo junto, y la slide del “universo de keywords” mezcla fuentes en una tabla: volumen de Ahrefs, una query que sale de Search Console (“is it cheaper to fly on a tuesday”), otra que sale de un competidor y otra de Reddit (“cheapest way to get to lisbon”).
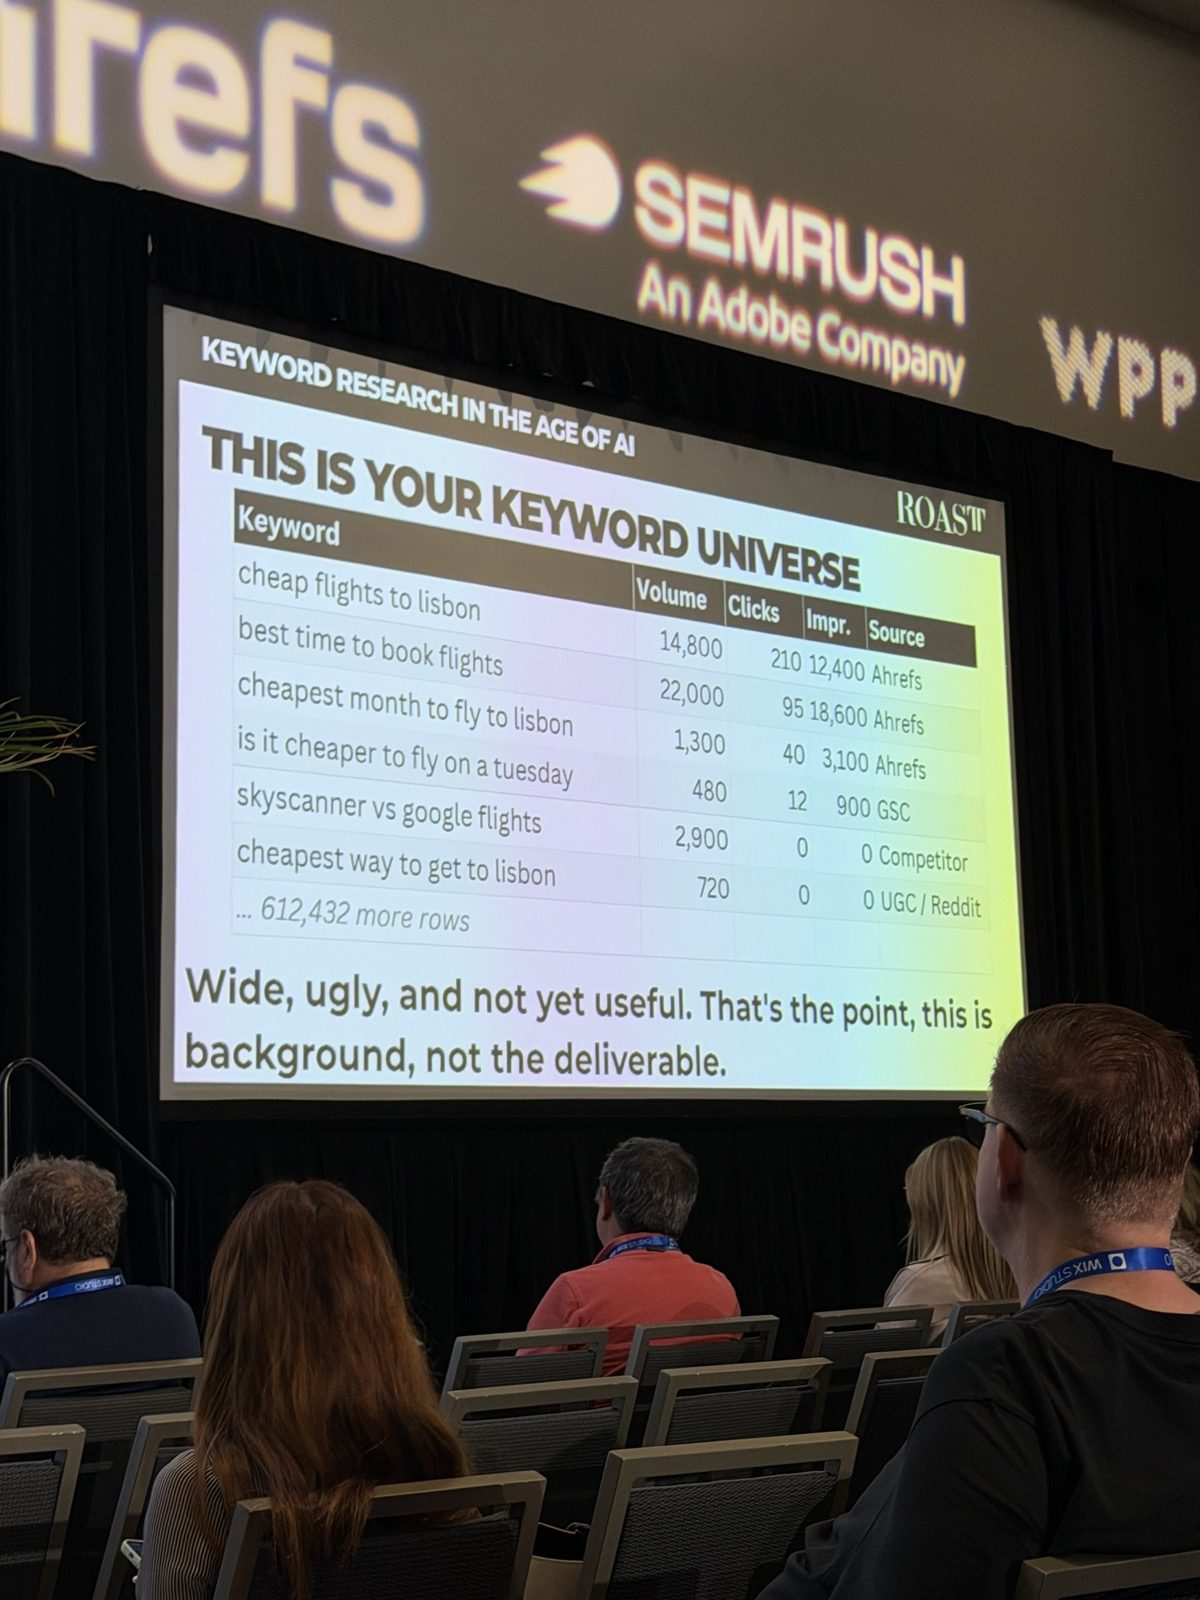
El pie de la slide lo dice: 612.432 filas más, “anchas, feas y todavía inútiles”, porque eso es insumo y no entregable. Con IA clasifica cada keyword por perfil y por etapa de decisión, y el entregable es un panel por perfil. En el ejemplo, el perfil “Deal-Finder Dana” en el cluster de cuándo comprar el pasaje tiene 7.896 keywords, 80,5K de volumen, 30,5K impresiones, 700 clicks y 2,3% de CTR, más quién rankea (Skyscanner, Kayak, Momondo, Expedia, Reddit) y las preguntas de “People also ask”.
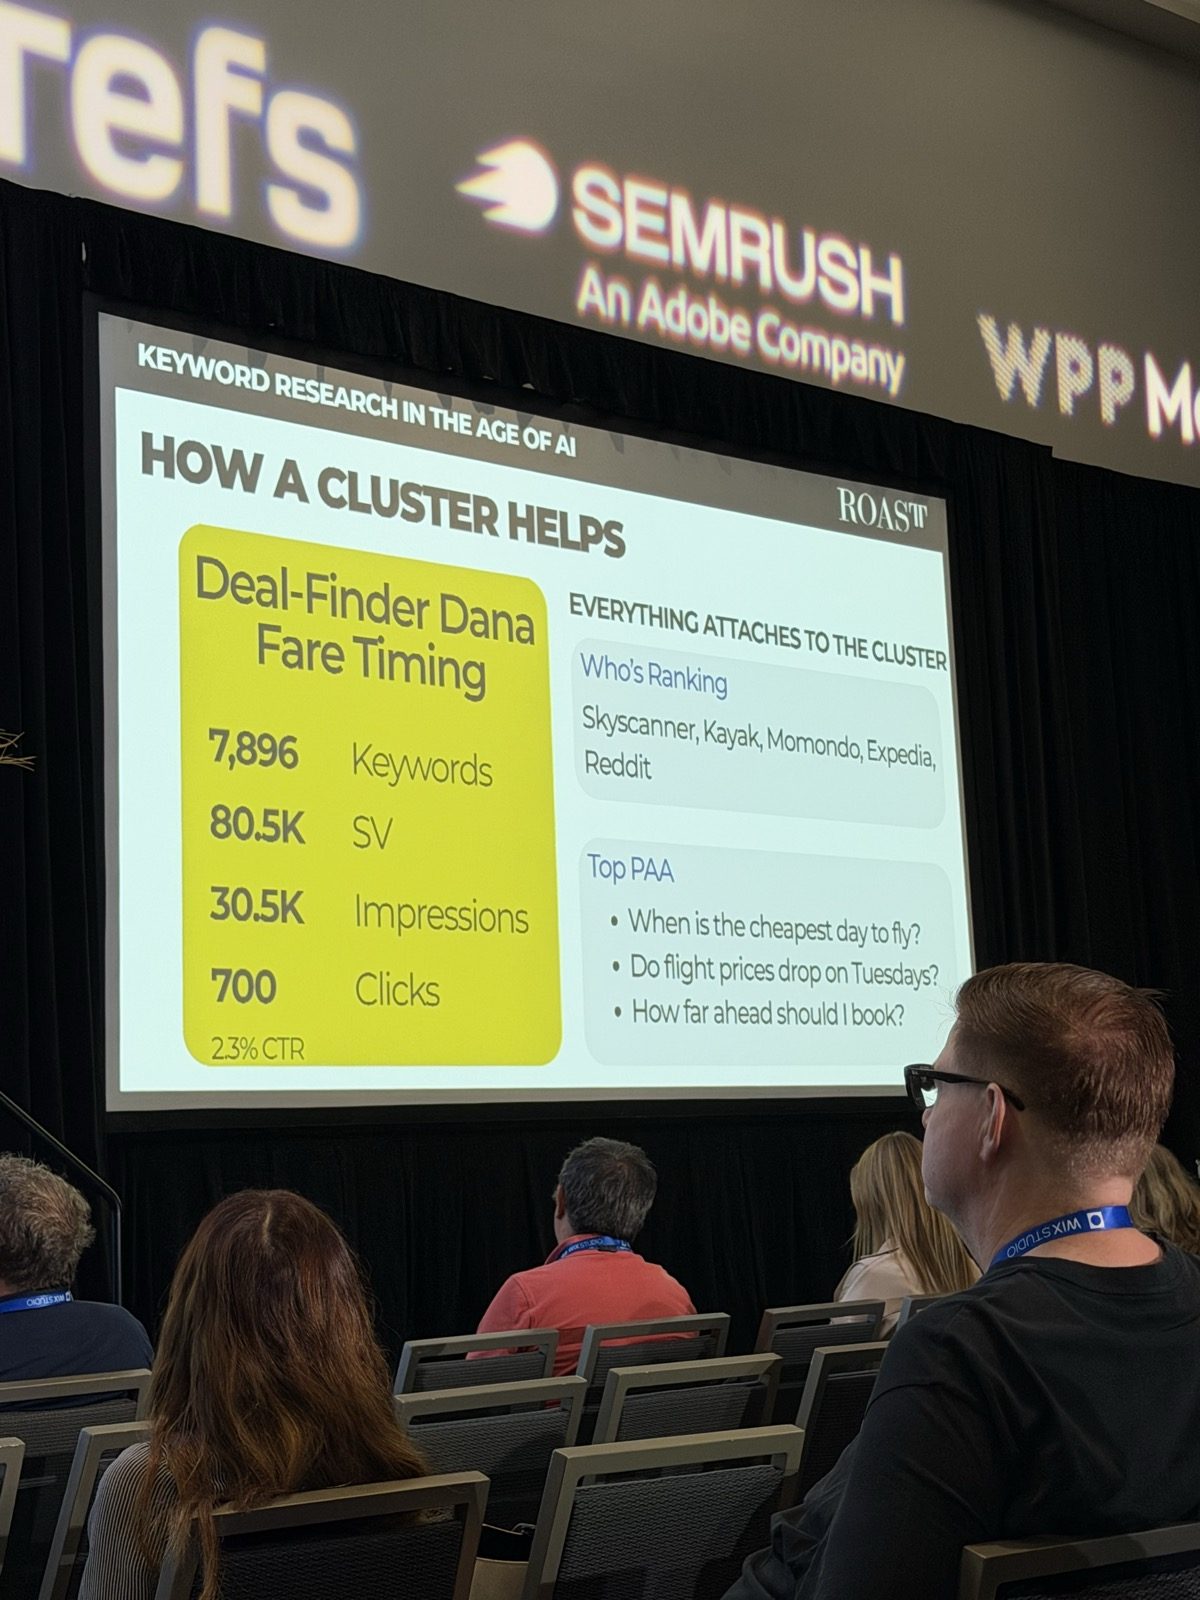
En ese panel el volumen es una fila de cinco, y las otras cuatro salen de Search Console o del SERP.
Purvi Sharma llevó la misma idea a un número en “Predictive SEO: Forecasting Rankings, Demand & Organic Visibility Using AI”, el miércoles 16. De esa charla tengo fotos y no tengo audio. Su opportunity score va de 0 a 100 y publica los pesos: crecimiento proyectado 35%, brecha contra competidores 25%, inestabilidad del SERP 20%, match de intención 12% y volumen base 8%. Arriba de 80 se prioriza, entre 60 y 79 se monitorea, debajo de 60 se desprioriza.
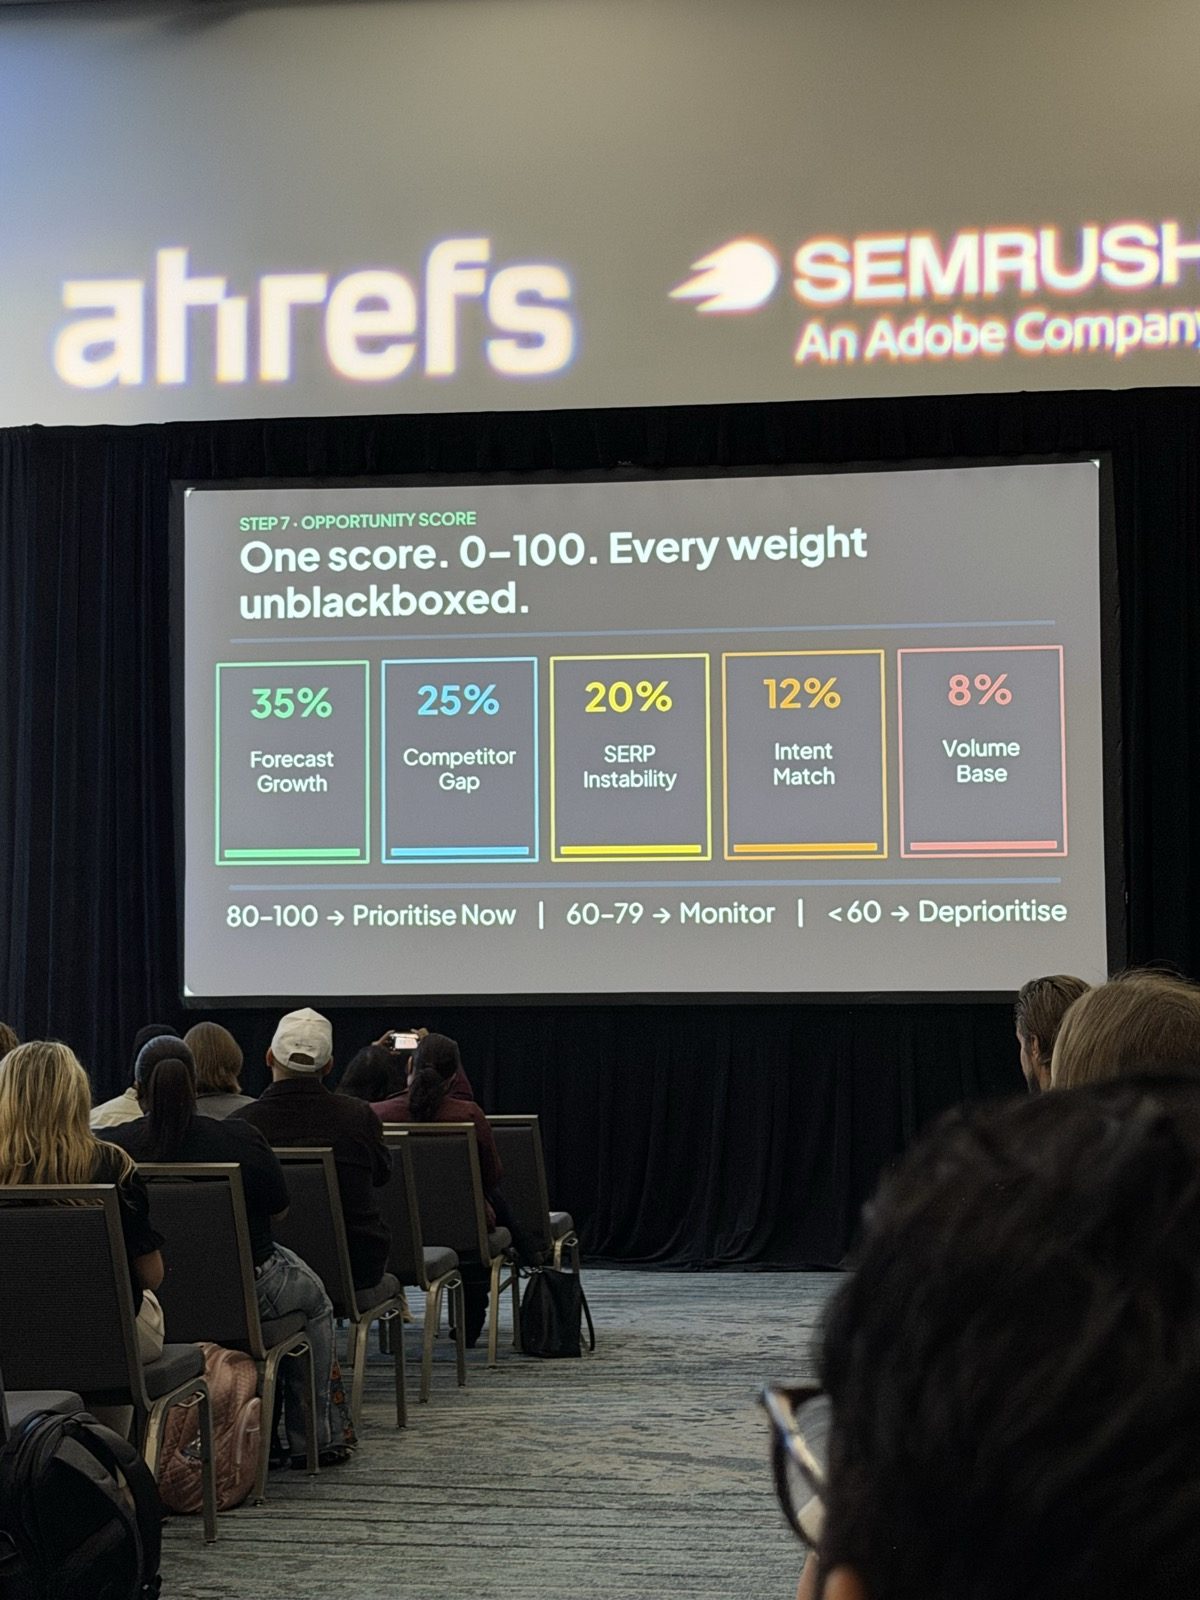
La aclaración: el peso más grande, 35%, depende de un forecast cuya precisión no pude verificar (no hay desgrabación ni muestra declarada), así que el score entero no lo copio. Lo que me llevo es el último número: en un score armado para priorizar, el volumen pesa 8%.
¿Qué preguntan los compradores que ninguna herramienta de keywords muestra?
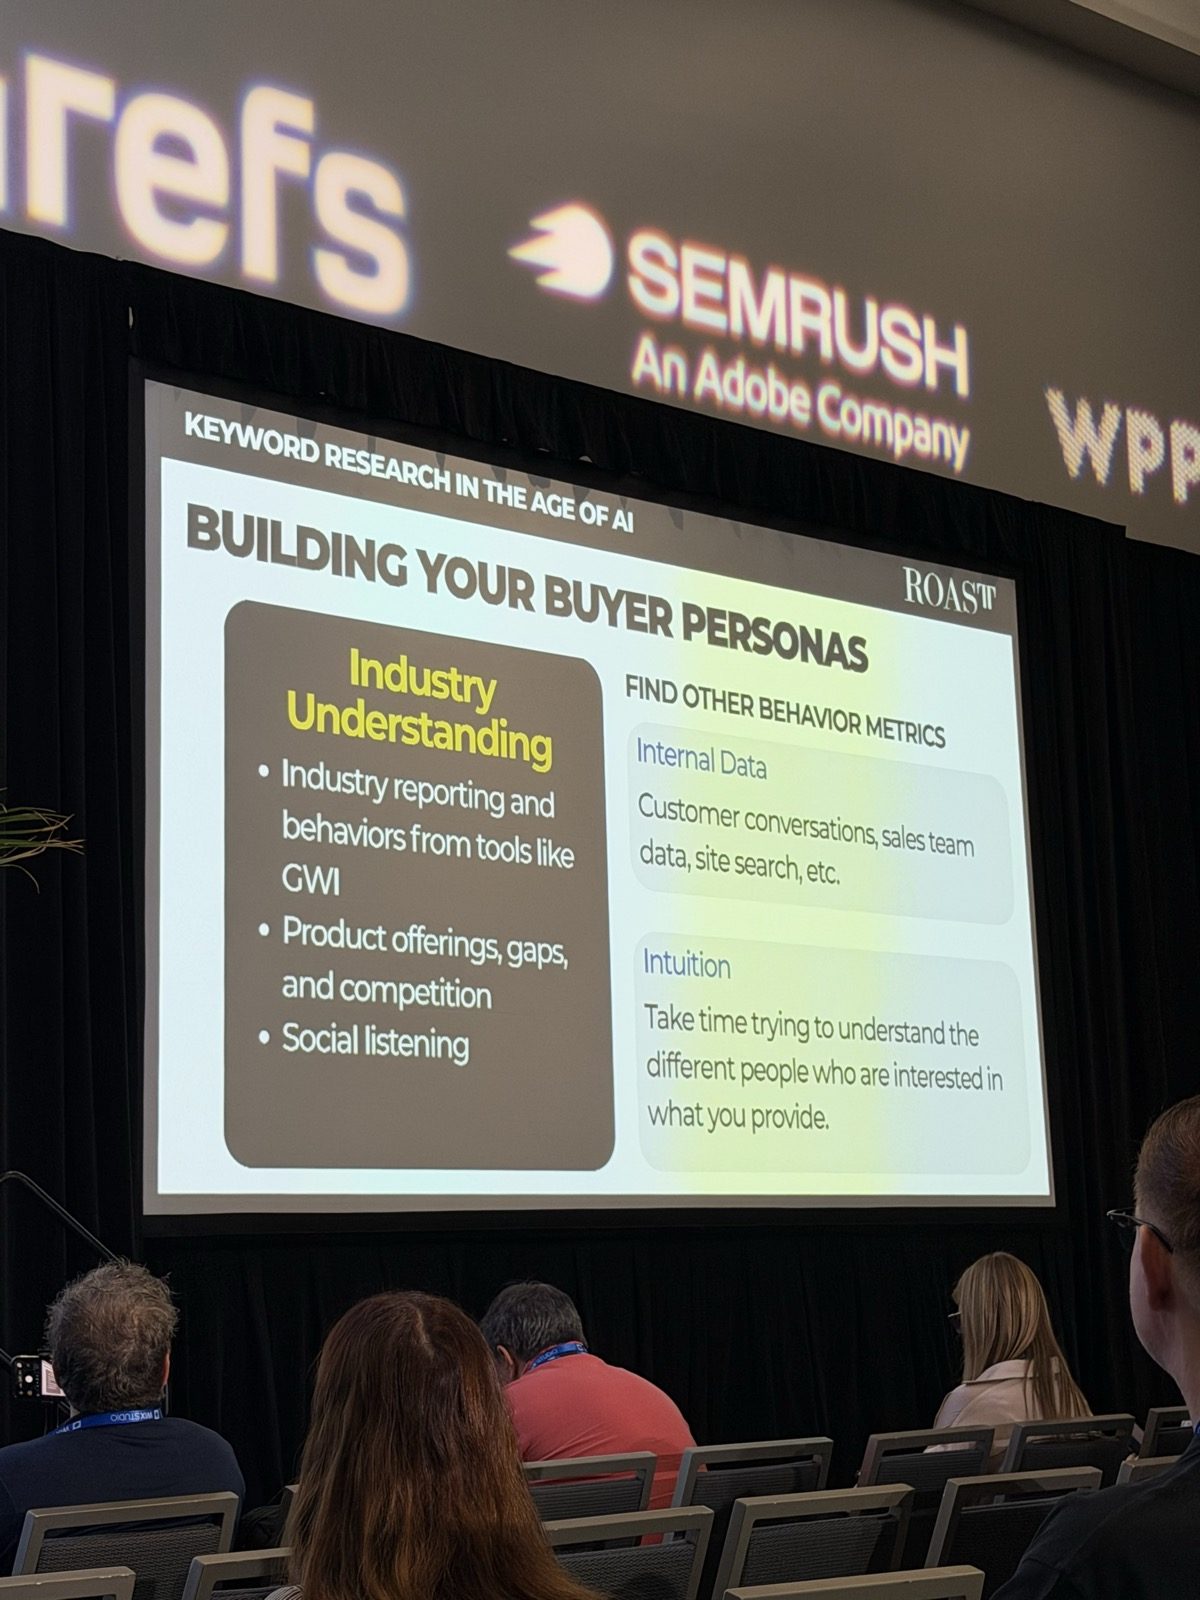
Entre las fuentes para armar los perfiles, la slide de Louderback lista como datos internos las conversaciones con clientes, los datos del equipo de ventas y el buscador interno del sitio. En la charla: “this comes back to talking to your sales team. That is a very important thing.”
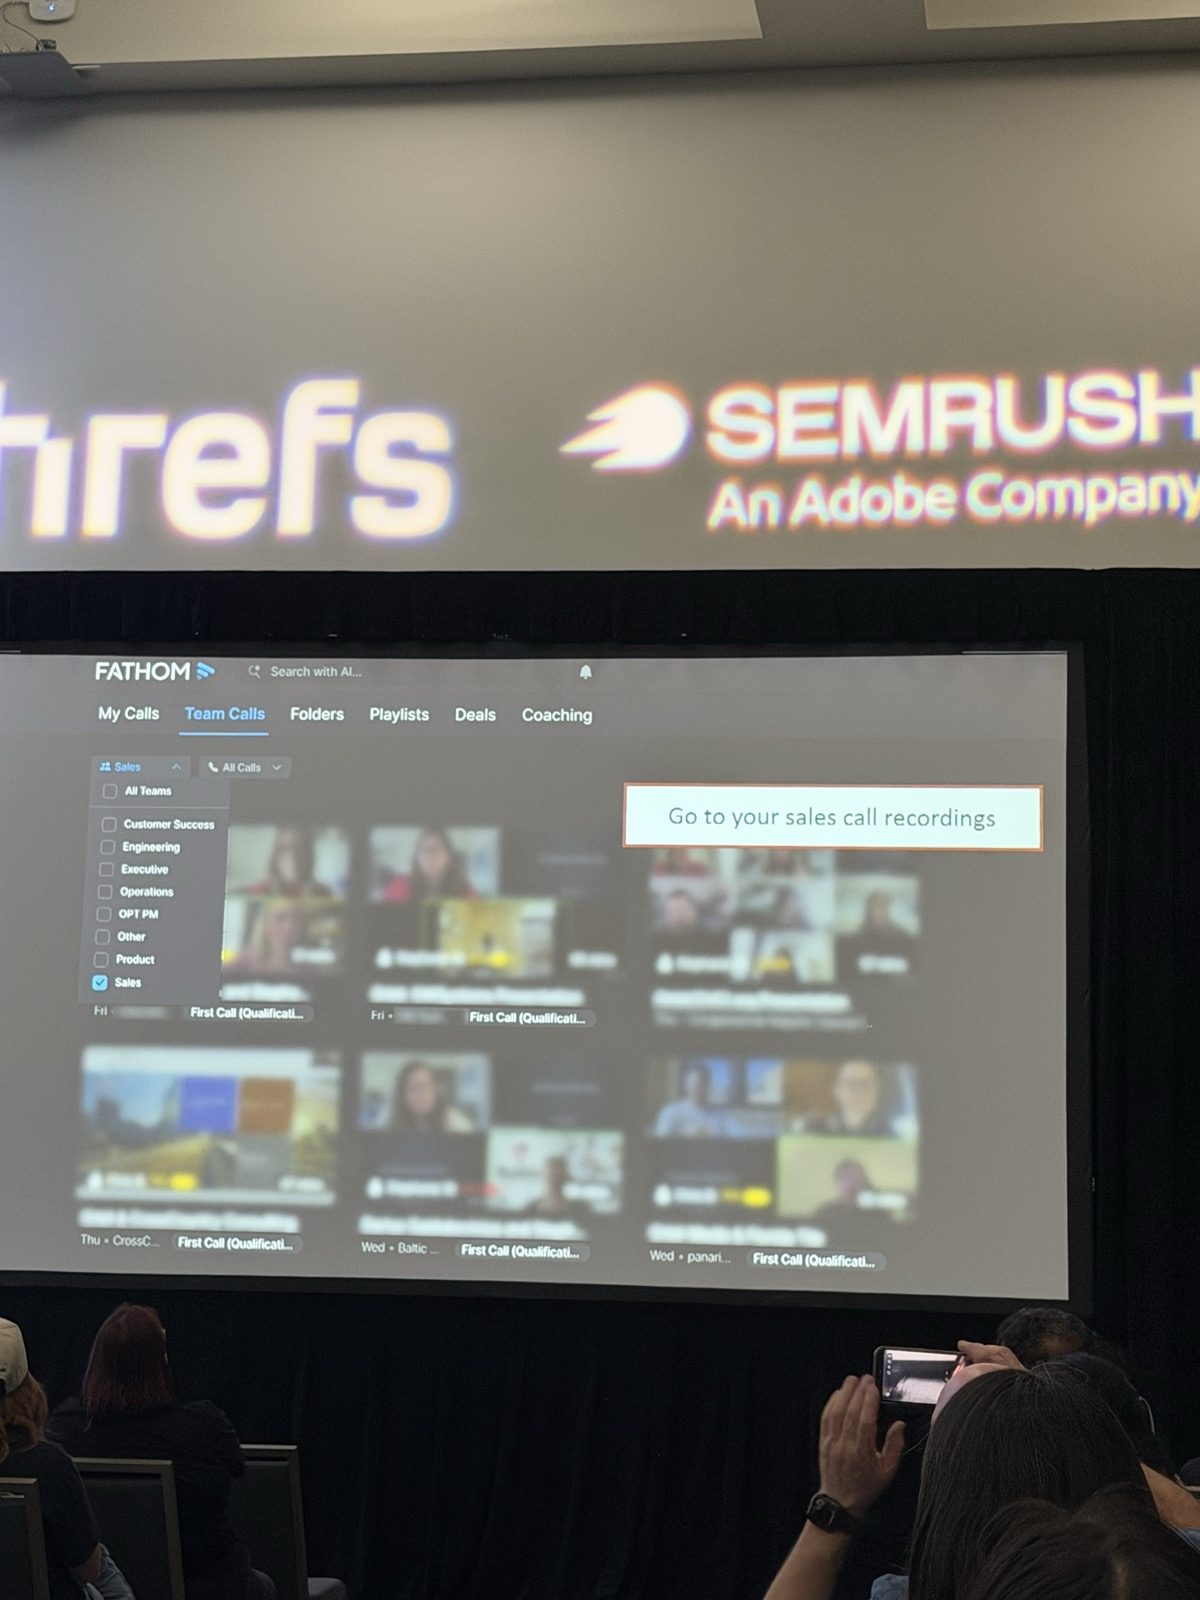
Andy Crestodina, de Orbit Media, cerró el miércoles con el keynote y fue más directo. Una slide: “What questions do your prospects ask? There’s only one way to find out…”. La siguiente era la pantalla de Fathom, su grabador de llamadas, filtrada por el equipo de ventas, con el texto “Go to your sales call recordings”.
Después mostró lo que salió de 91 llamadas de ventas, agrupado por tema y con las frases literales de los prospects. Los puestos 7, 8 y 9 de su lista empatan: diseño y marca, plazos (“How long does it take?”) y SEO y rankings (“Do you see things changing yet with AI technology to affect the ranking as well?”), cada uno en 16 de 91 llamadas. Más arriba en la lista están las preguntas por la plataforma: “Are you WordPress?”.
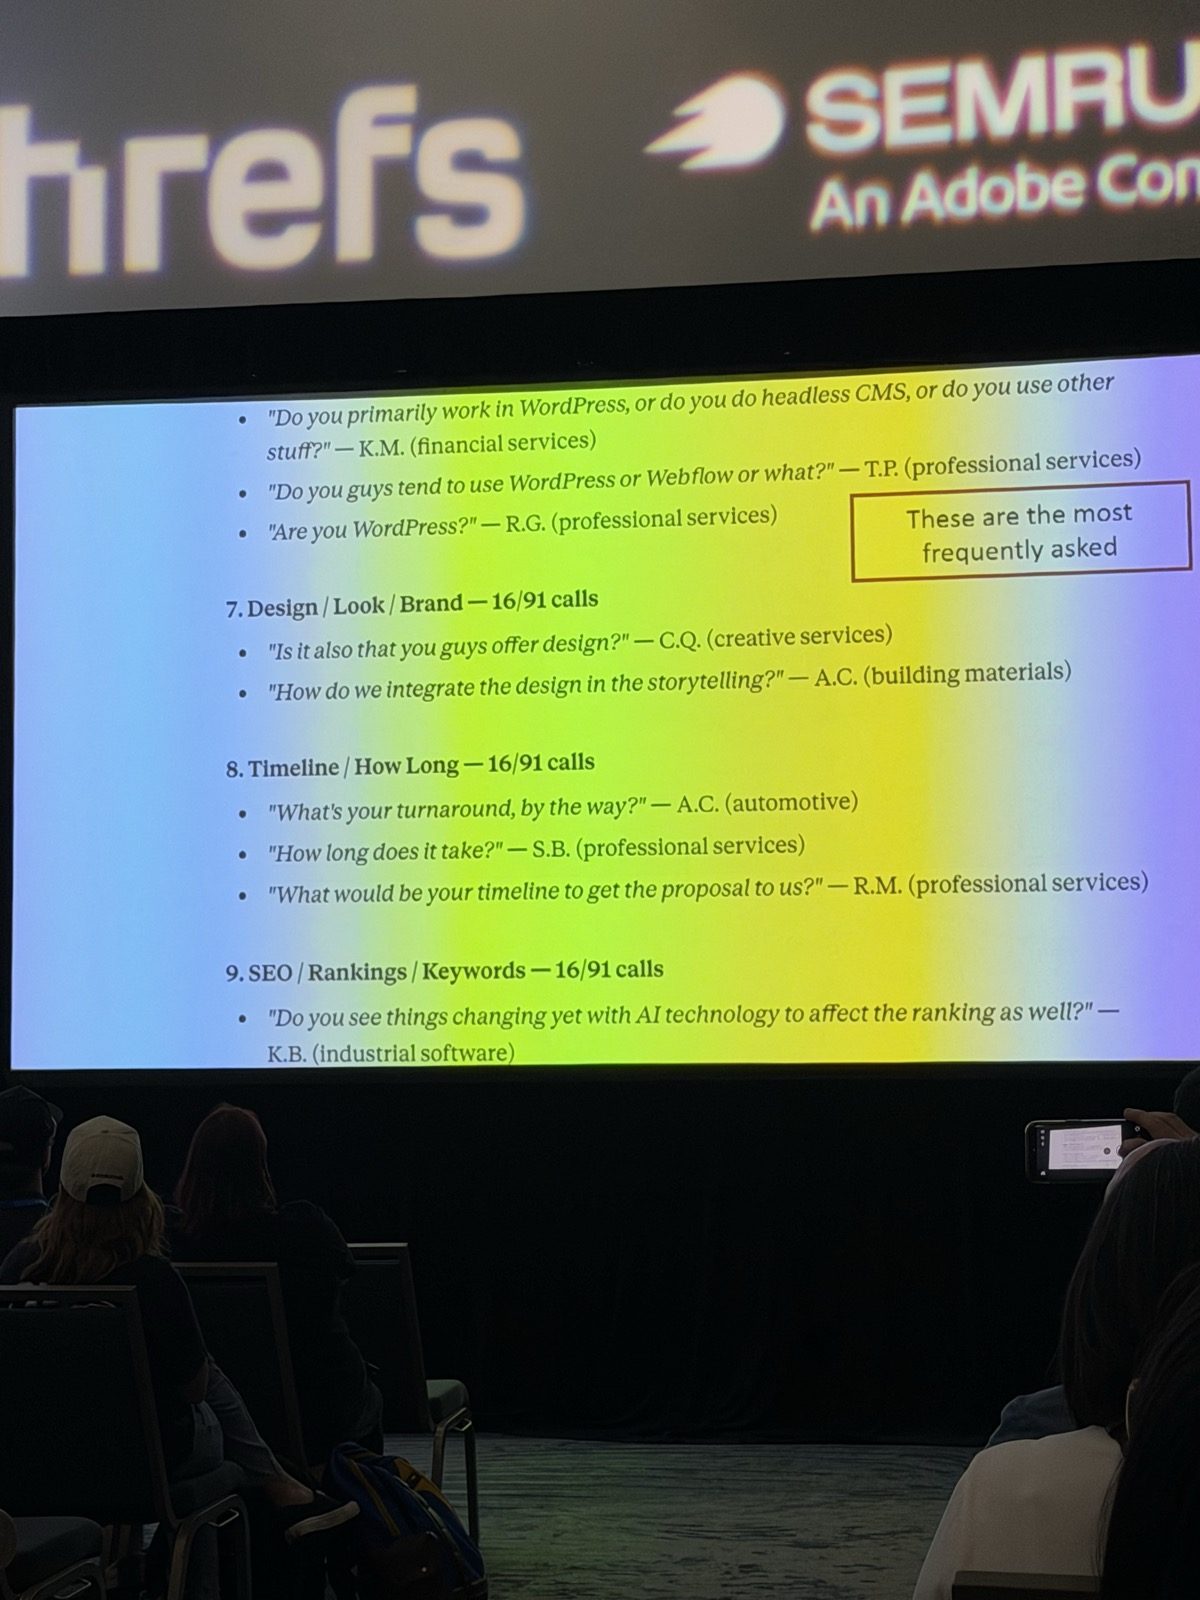
Es la agencia de quien cerró un evento de SEO, y el SEO aparece en 16 de las 91 llamadas de sus prospects, empatado con diseño y plazos. Ninguna herramienta de volumen te devuelve eso.
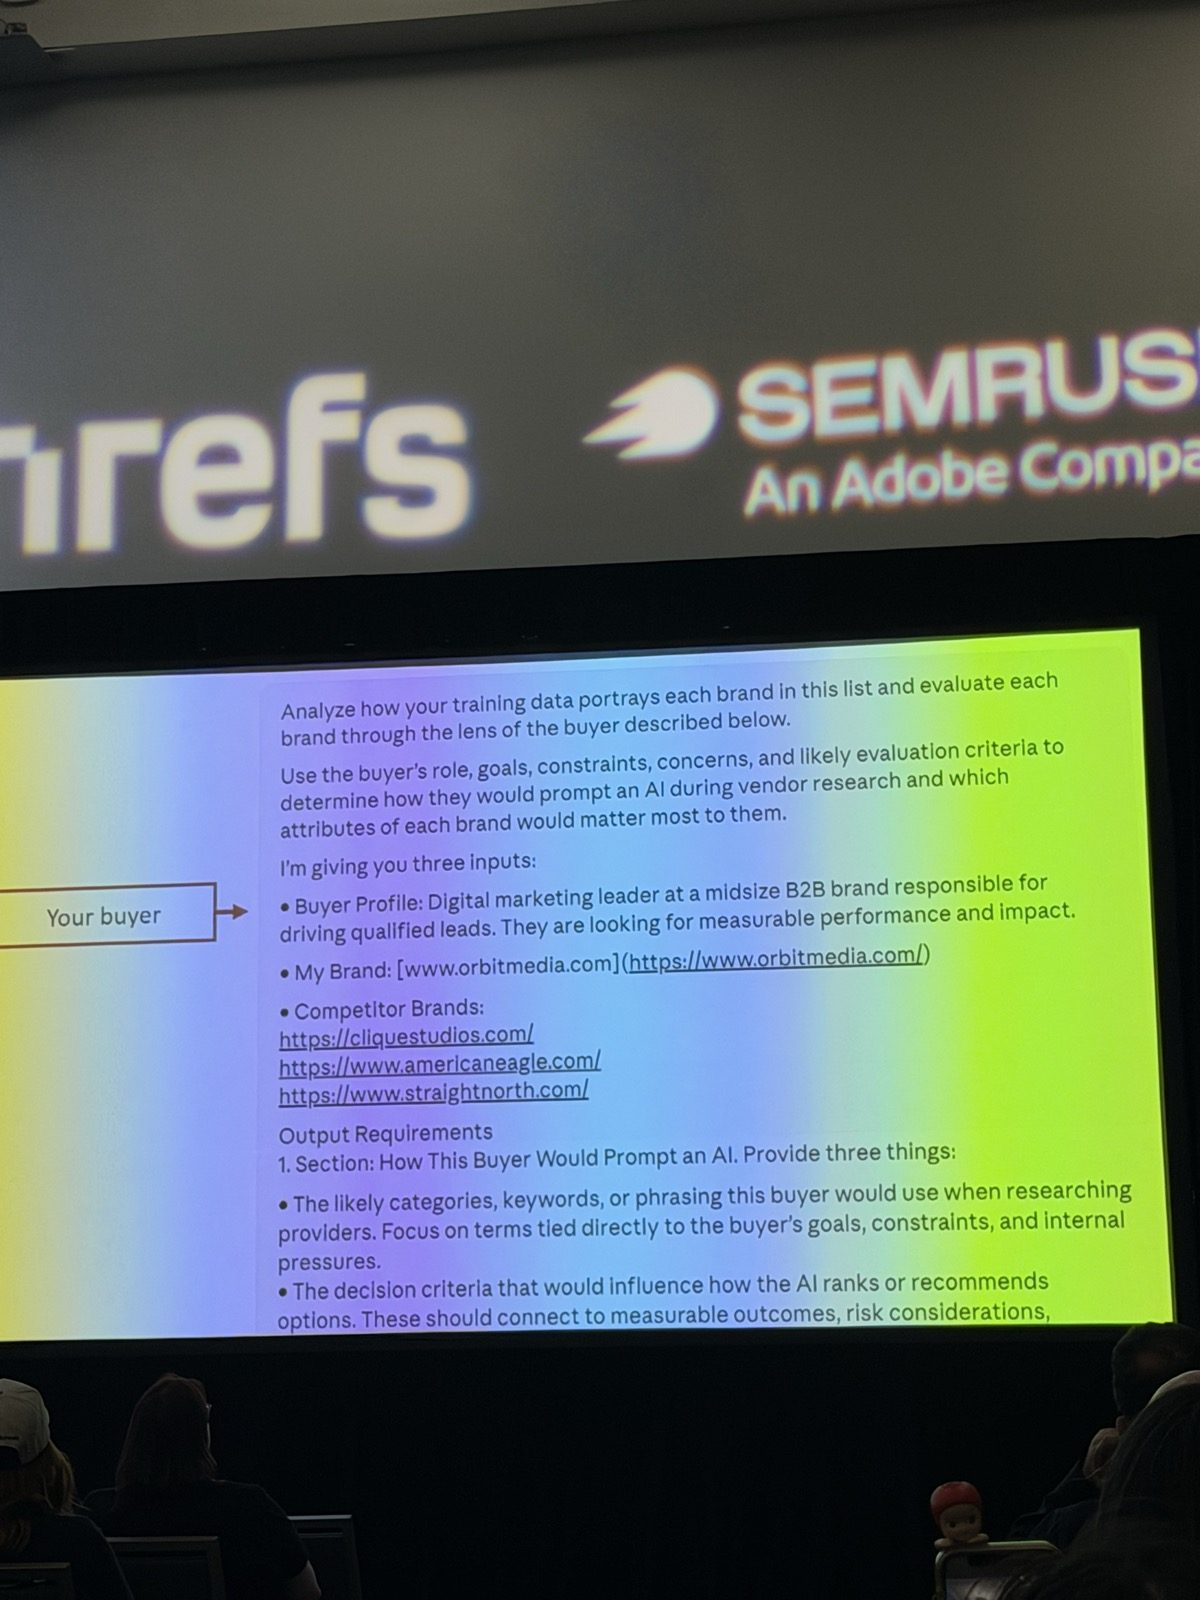
Crestodina conectó las llamadas con la visibilidad en IA mediante un prompt: “Analyze how your training data portrays each brand in this list and evaluate each brand through the lens of the buyer described below”. Los insumos son tres: un perfil de comprador, tu marca y tus competidores.
El resultado que mostró sobre su propia agencia tenía como primera debilidad que el modelo no la ubica en la categoría que el comprador busca: “Not category-coded as a lead generation or demand gen agency — misses the buyer’s opening prompt entirely”. La segunda: su prueba es educativa (posts, investigación) y no numérica, que es lo que ese comprador pide.
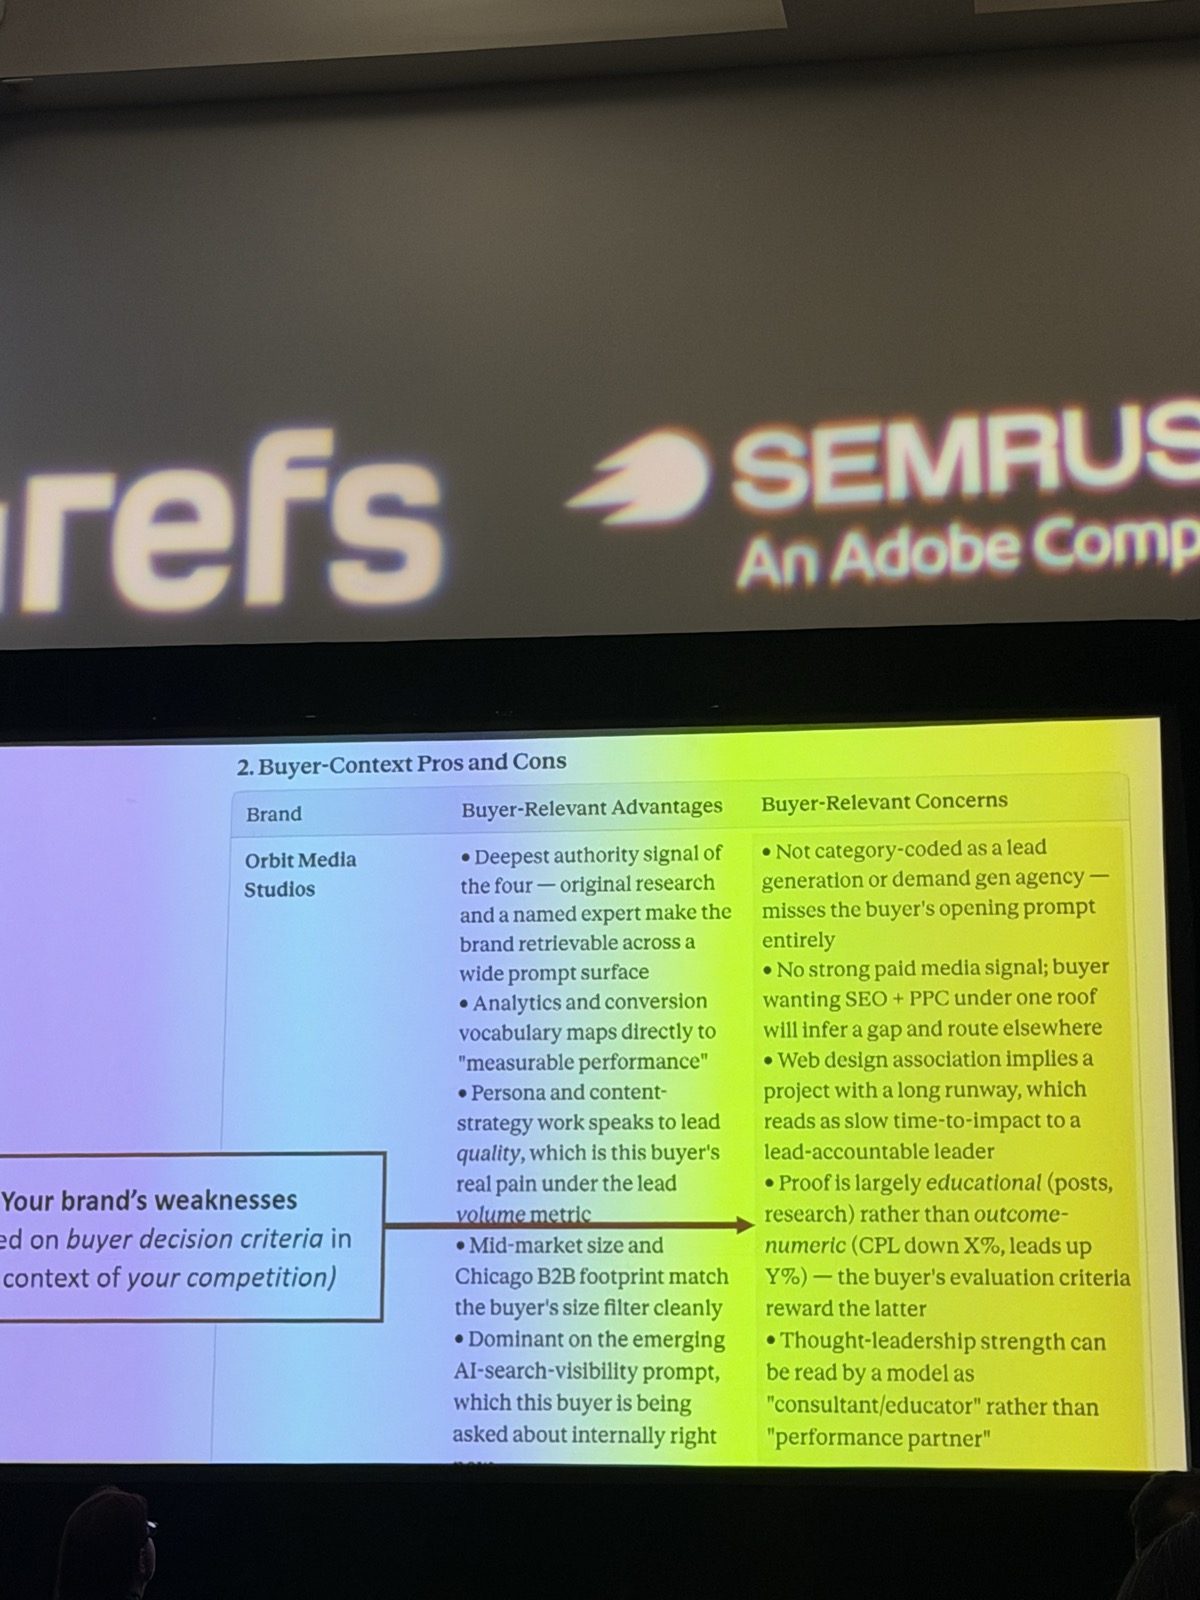
La aclaración: es el output de un modelo sobre una sola marca, sin muestra. Lo que muestra es el método. El prompt necesita un perfil de comprador real, y ese perfil sale de las llamadas, no del planner.
¿Qué hago distinto en un keyword research ahora?
Cada fuente tiene un punto ciego distinto:
| Fuente | Qué te dice | Qué no te dice |
|---|---|---|
| Volumen (planner y herramientas que lo usan) | Demanda cabeza y comparación entre términos ya estandarizados | Variantes agrupadas, mínimos redondeados, terminología que el mercado todavía no estandarizó |
| Search Console, query × página | Demanda que ya llega al sitio, con posición, impresiones y clicks | Lo que no rankeás, y las queries anonimizadas (64% de las impresiones en el caso del blog de hipotecas) |
| Llamadas de ventas y de atención | Vocabulario, preguntas y objeciones del comprador | Volumen, y la parte que instala el vendedor |
| Prompt tracking | Cómo responde un motor de IA en una muestra de prompts | Impresiones: Louderback lo dijo en la charla, “there’s really no impression data when it comes to prompts”. Y es muestreo: mismo prompt, mismo día, distintos usuarios, distinto resultado |
En la práctica, el orden que uso es este:
- Arrancar por el universo completo de Search Console, query × página, no por una muestra de las queries cabeza.
- Cruzarlo contra volumen para ver qué queda afuera del radar, no para filtrar.
- Leer las llamadas de ventas y de atención separando lo que trae el comprador de lo que dice el vendedor.
- Mantener la keyword con volumen y llevar el vocabulario del comprador a H2, FAQ y copy.
- Derivar los prompts a trackear de esas búsquedas y preguntas. Louderback contó el caso de un cliente que trackeaba prompts que sus usuarios no hacían.
El volumen te dice cuánta gente escribe una palabra que vos ya elegiste. Search Console y las llamadas te dicen qué palabra elegir. ¿Alguien más está cruzando llamadas de ventas contra Search Console de forma sistemática?
Serie brightonSEO San Diego 2026
- ¿Cómo medir el impacto de la IA en tu negocio? En leads y marca, no en el tráfico de ChatGPT
- ¿Qué fuentes cita la IA cuando habla de tu marca? Depende del rubro y del motor
- ¿Por qué una página lenta queda afuera de las respuestas de IA? SEO técnico para bots, con logs
- ¿Qué página cita la IA? La que responde arriba y respalda lo que afirma
- Agentes de IA en SEO: ¿dónde tiene que parar la automatización?
- ¿El volumen de búsqueda mide la demanda? Dónde está la demanda real (este artículo)
- Autoridad offsite en IA: ¿dónde tiene que estar tu marca cuando el motor arma la respuesta?
- ¿Cómo le habla el SEO a dirección ahora que la IA le abrió la puerta?
Toda la serie en un solo lugar: brightonSEO 2026.