Publicado en nicolasbillia.com — Octubre 2026 · Serie brightonSEO San Diego 2026
Disclaimer
Este contenido fue escrito con ayuda de IA a partir de mis desgrabaciones y fotos de las charlas de brightonSEO + Hero Conf San Diego (15 y 16 de septiembre de 2026) y de datos de proyectos de Nomadic. Los datos del evento llevan el nombre de quien los presentó; los de clientes van sin nombre y por rubro. Las fotos de las slides son mías.
En corto
- Los dos speakers de agentes que mostraron números en brightonSEO automatizaron lo que se repite (crawlear, cruzar datos, preparar el brief, escribir el primer borrador). Ninguno automatizó la decisión.
- Los dos pusieron un corte explícito: el agente de Mike Korenugin nunca publica, y el audit de John Caiozzo termina en una tabla que prioriza una persona y arregla un dev.
- El agente que escribe mal se ve. El que cuesta caro es el control que da verde sin haber controlado nada: nos pasó en dos pipelines propios.
- Quién revisa importa tanto como dónde se corta: un verificador sin el contexto de producción, que mira los archivos y no el reporte del que produjo.
- Con un agente escala el volumen. El criterio hay que escribirlo antes: qué se chequea, con qué umbral, dónde para y qué pasa cuando el control falla.
¿Qué automatizaron los que mostraron resultados con agentes?
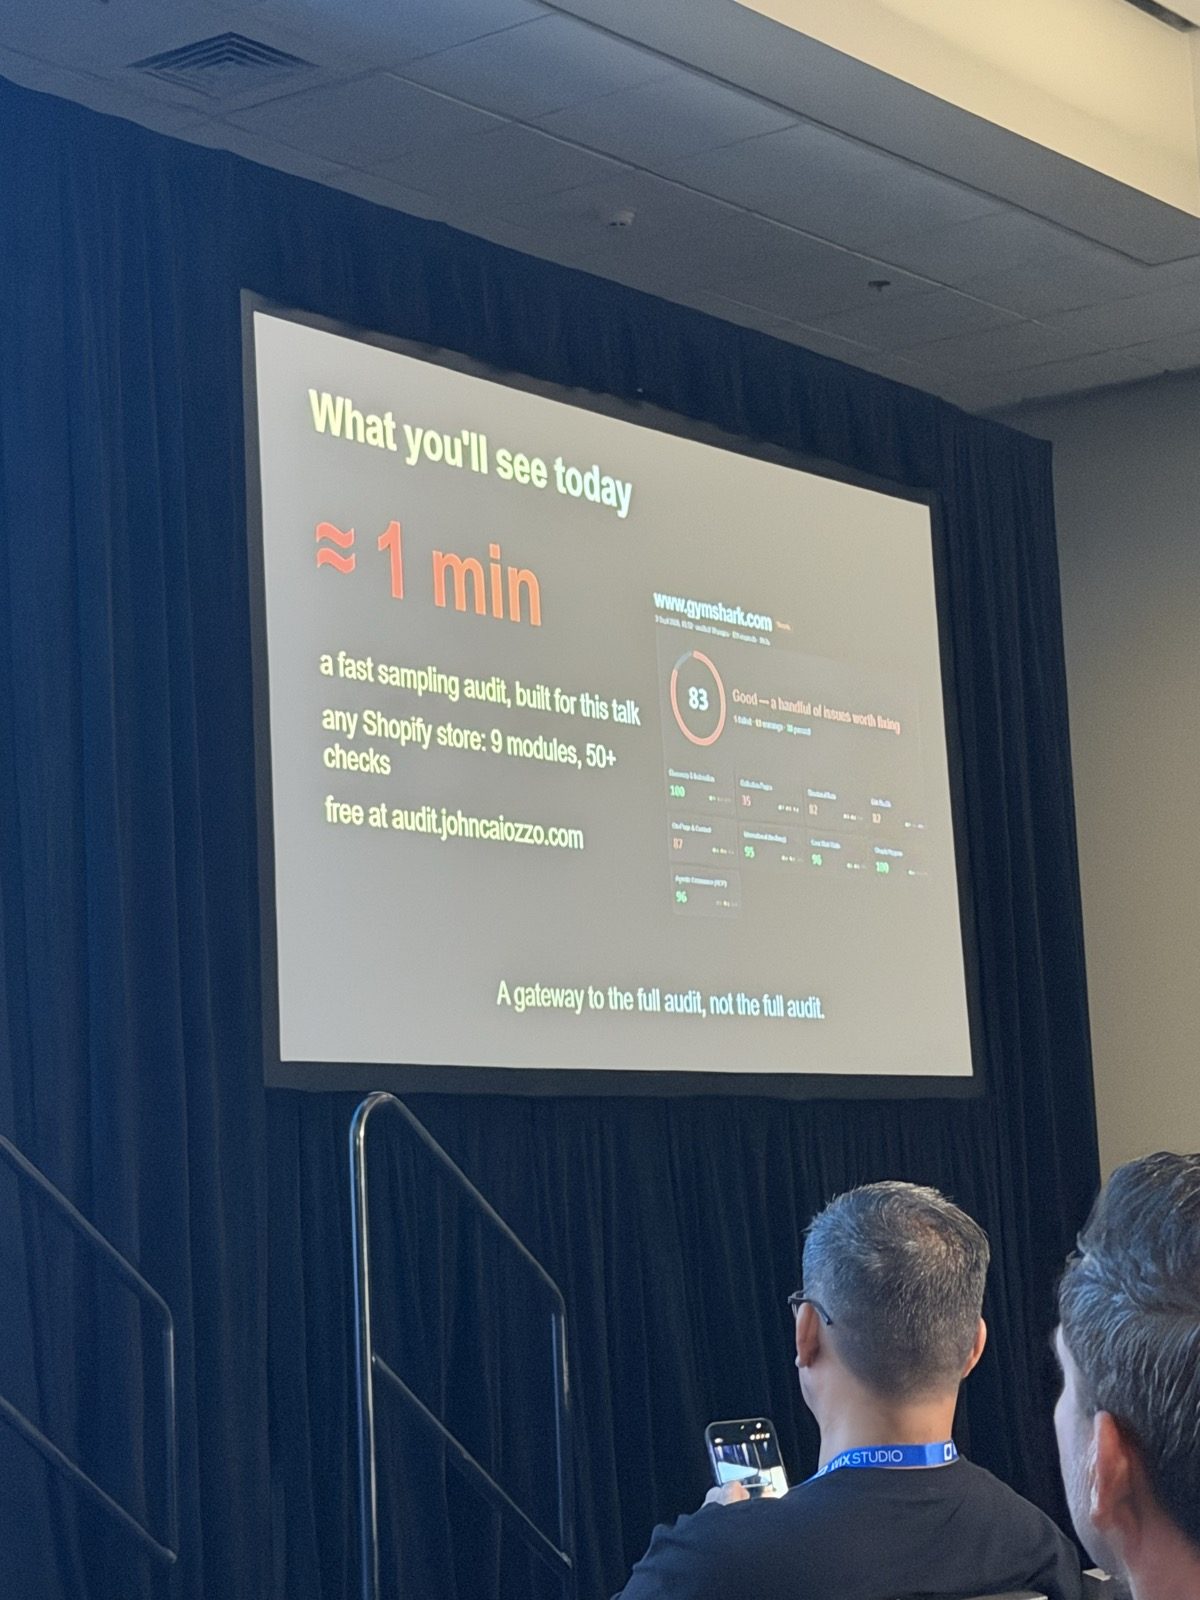
John Caiozzo (Caiozzo Consulting) dio “4 Hours to 30 Minutes: Automating High-Impact SEO Audits With Claude Code”. Audita ecommerce grandes, y ese trabajo le llevaba cuatro horas o un par de días. Hoy le lleva 30 minutos. Para sus clientes corre 18 áreas y más de 65 reglas, con una corrida completa de entre 30 minutos y una hora. En la demo en vivo crawleó 30 páginas en 39 segundos. La frase que me quedó no fue la del tiempo: “The best part about this isn’t the speed, though. It’s that I didn’t even have to remember to run it.”
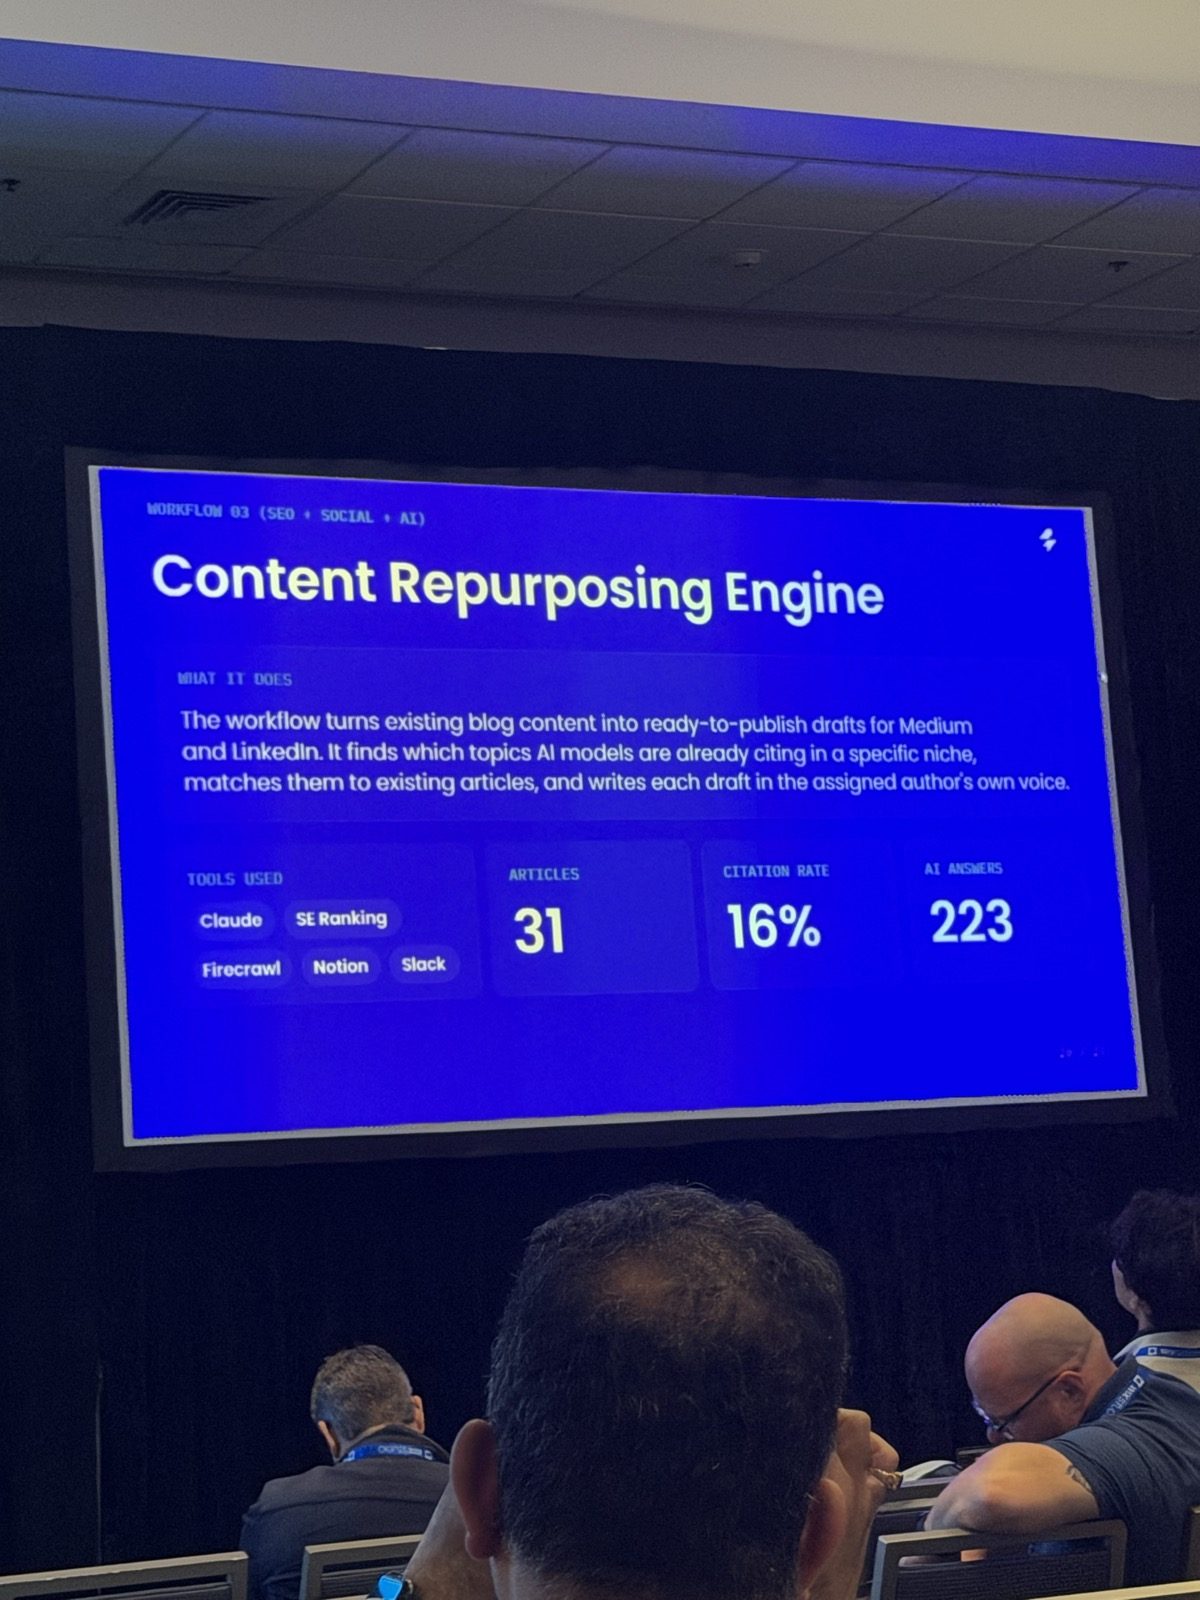
Mike Korenugin (SE Ranking) dio “Brand Visibility on Autopilot: Building AI Workflows With Agents, MCP, and Cross-Channel Data”. El caso es el sitio de SE Ranking: agentes que detectan qué temas citan los motores de IA y dónde no aparece la marca, eligen qué artículo actualizar, arman el research, escriben el borrador y vuelven a medir. Dice que ahorran más del 80% del tiempo en preparar briefs, el plan de anchors y la data de localización. La corrida semanal elige hasta 5 artículos de un inventario de miles. Para el workflow que convierte notas del blog en posteos de Medium y LinkedIn, la slide muestra 31 artículos, 16% de citation rate y 223 respuestas de IA.
Los dos automatizaron trabajo que se repite igual cada semana. Ninguno le pasó al agente la decisión de qué arreglar primero ni qué se publica.
¿Dónde pusieron el corte entre el agente y la persona?
Korenugin le dio una caja propia en la slide: “Automation stops here. The agent never publishes to the live blog. Editorial review and publication stay human.” Antes de llegar ahí, un segundo agente chequea hechos, reglas editoriales, voz de marca y que no se haya tocado nada fuera de lo aprobado. Explicó por qué existe ese segundo agente: “More often than not, the first draft is not going to be great.” Y en el cierre: “Claude will be so confidently wrong that if you don’t double check, it’s very likely that this is going to create some BS that you are going to regret later.”
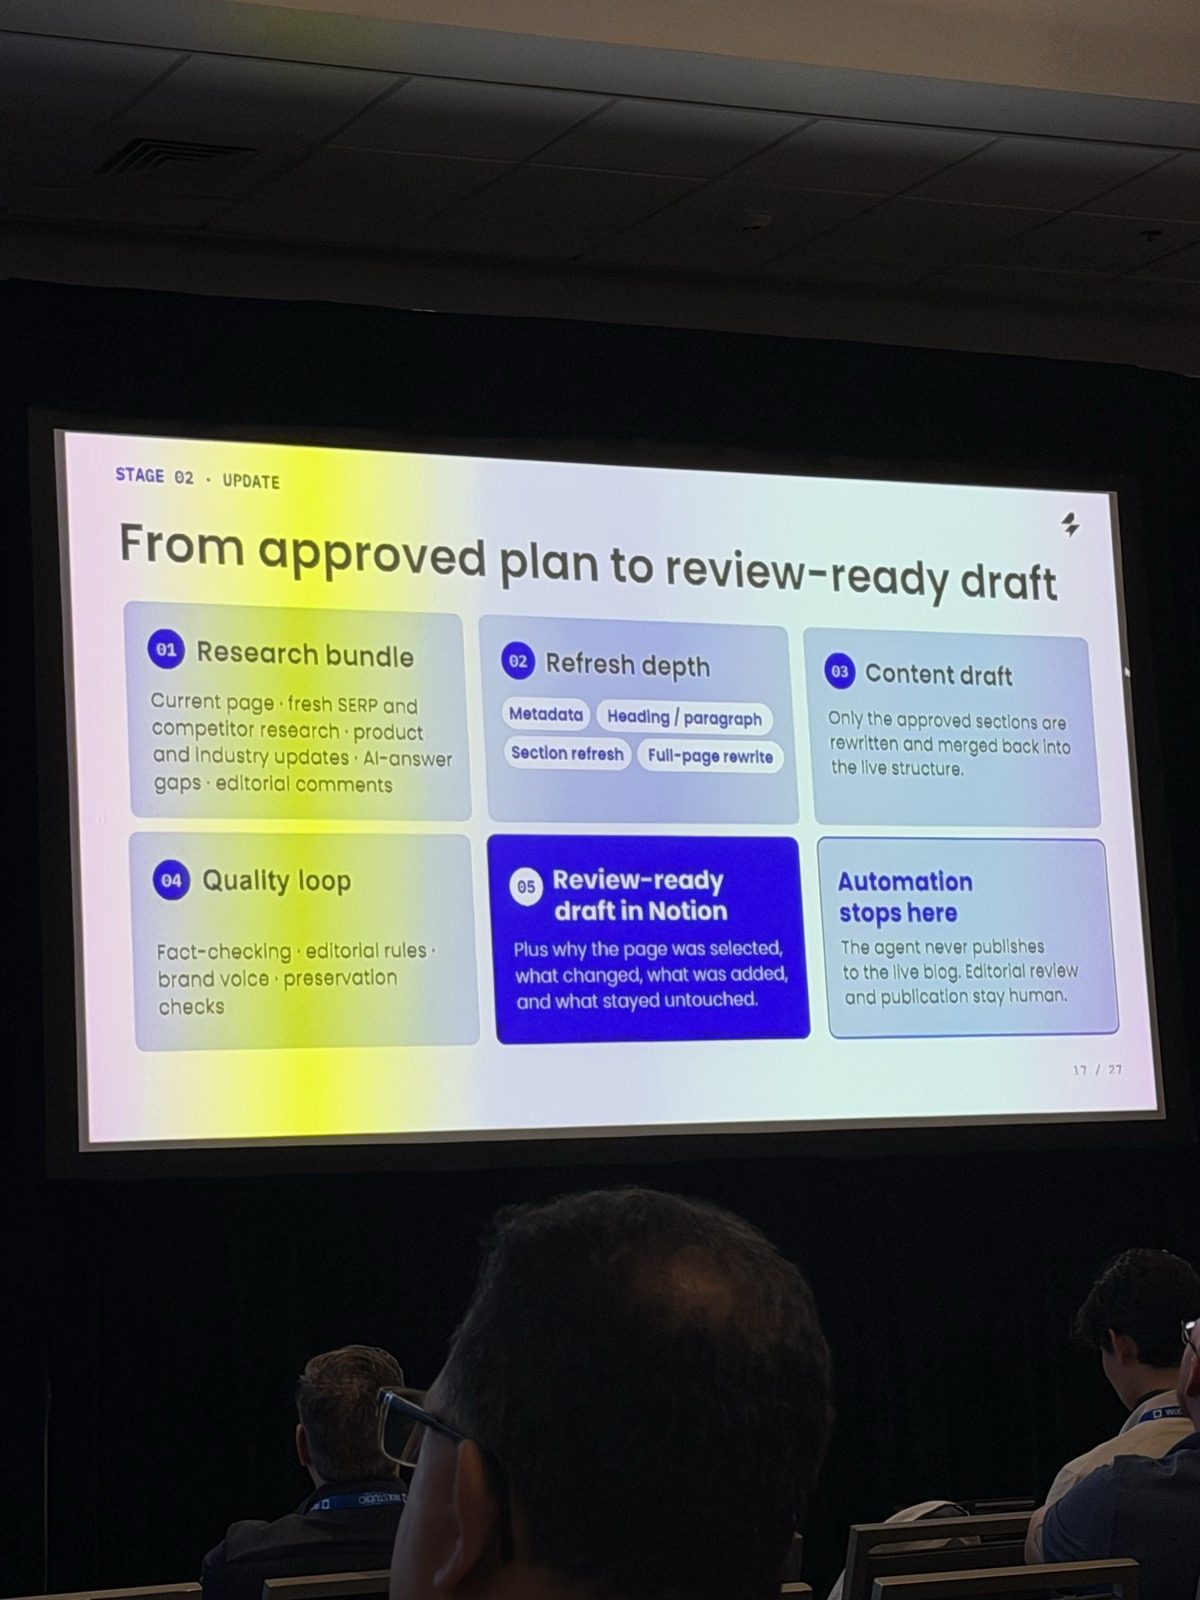
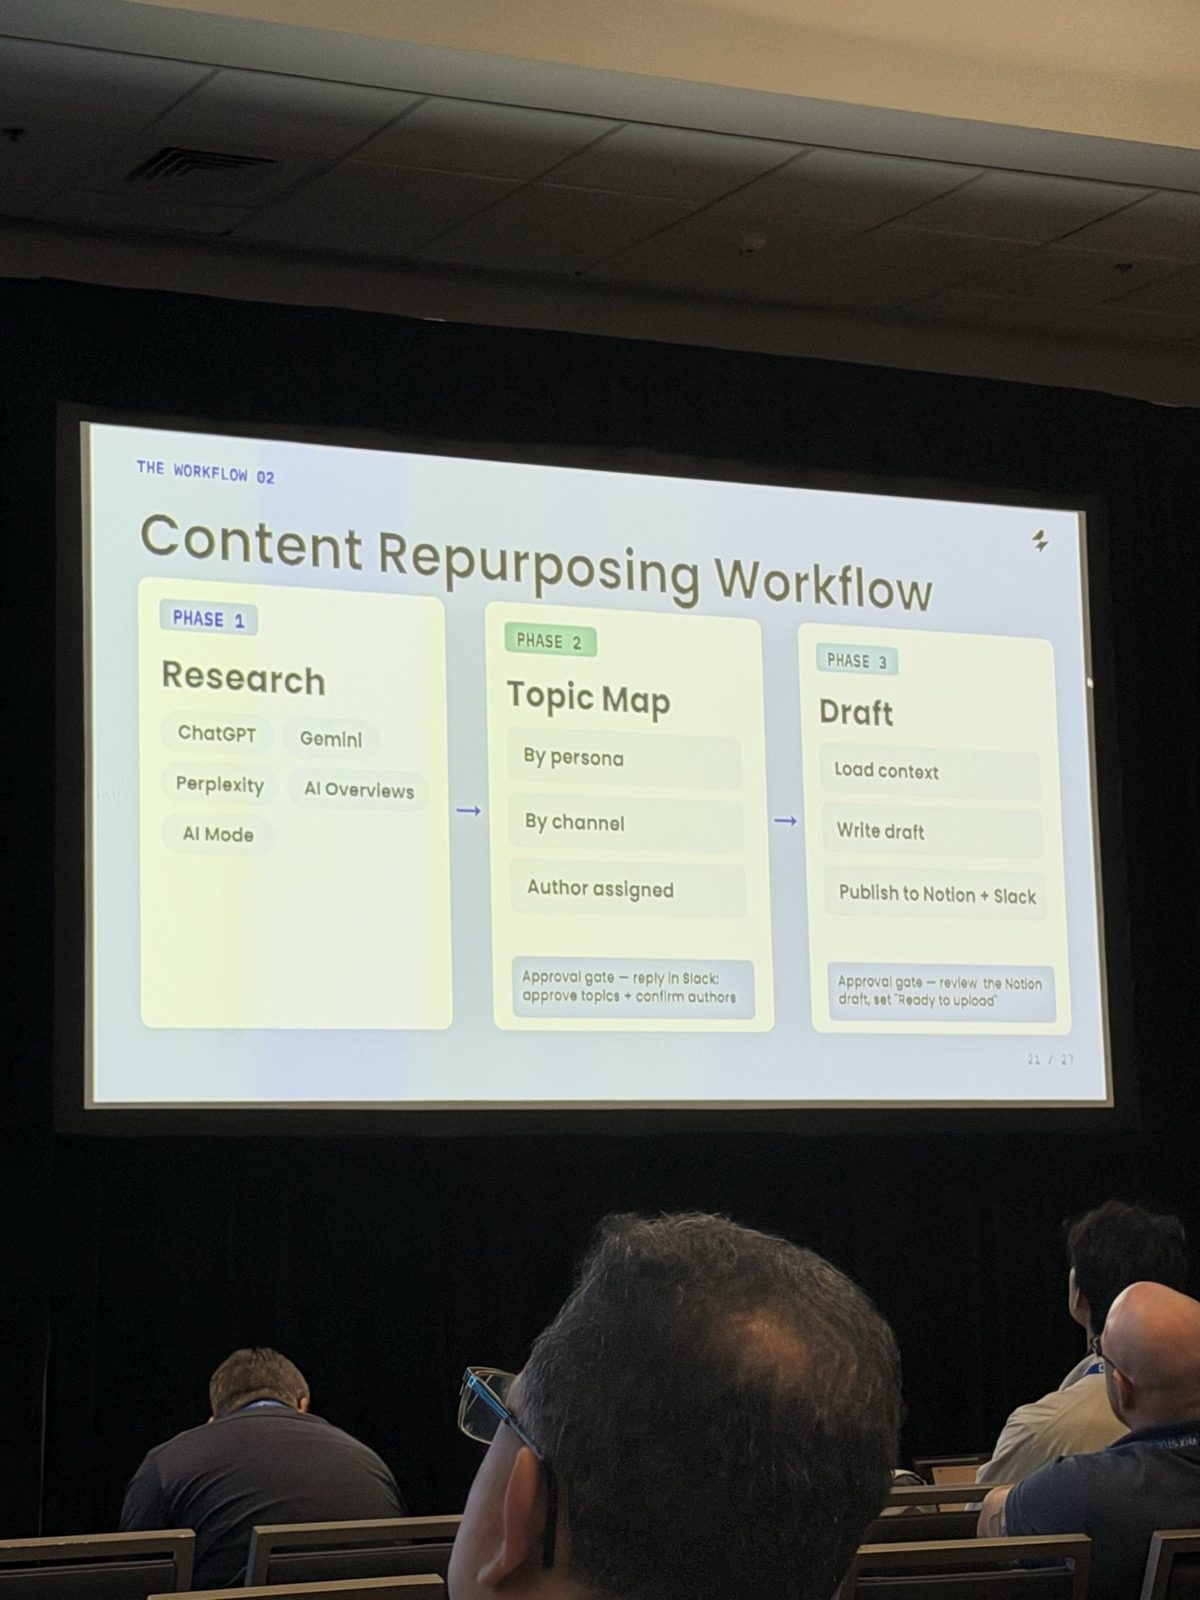
En el workflow de repurposing las aprobaciones humanas son dos y están dibujadas en la slide: una en Slack, para aprobar temas y autores, y otra en Notion, para revisar el borrador antes de marcarlo “Ready to upload”.
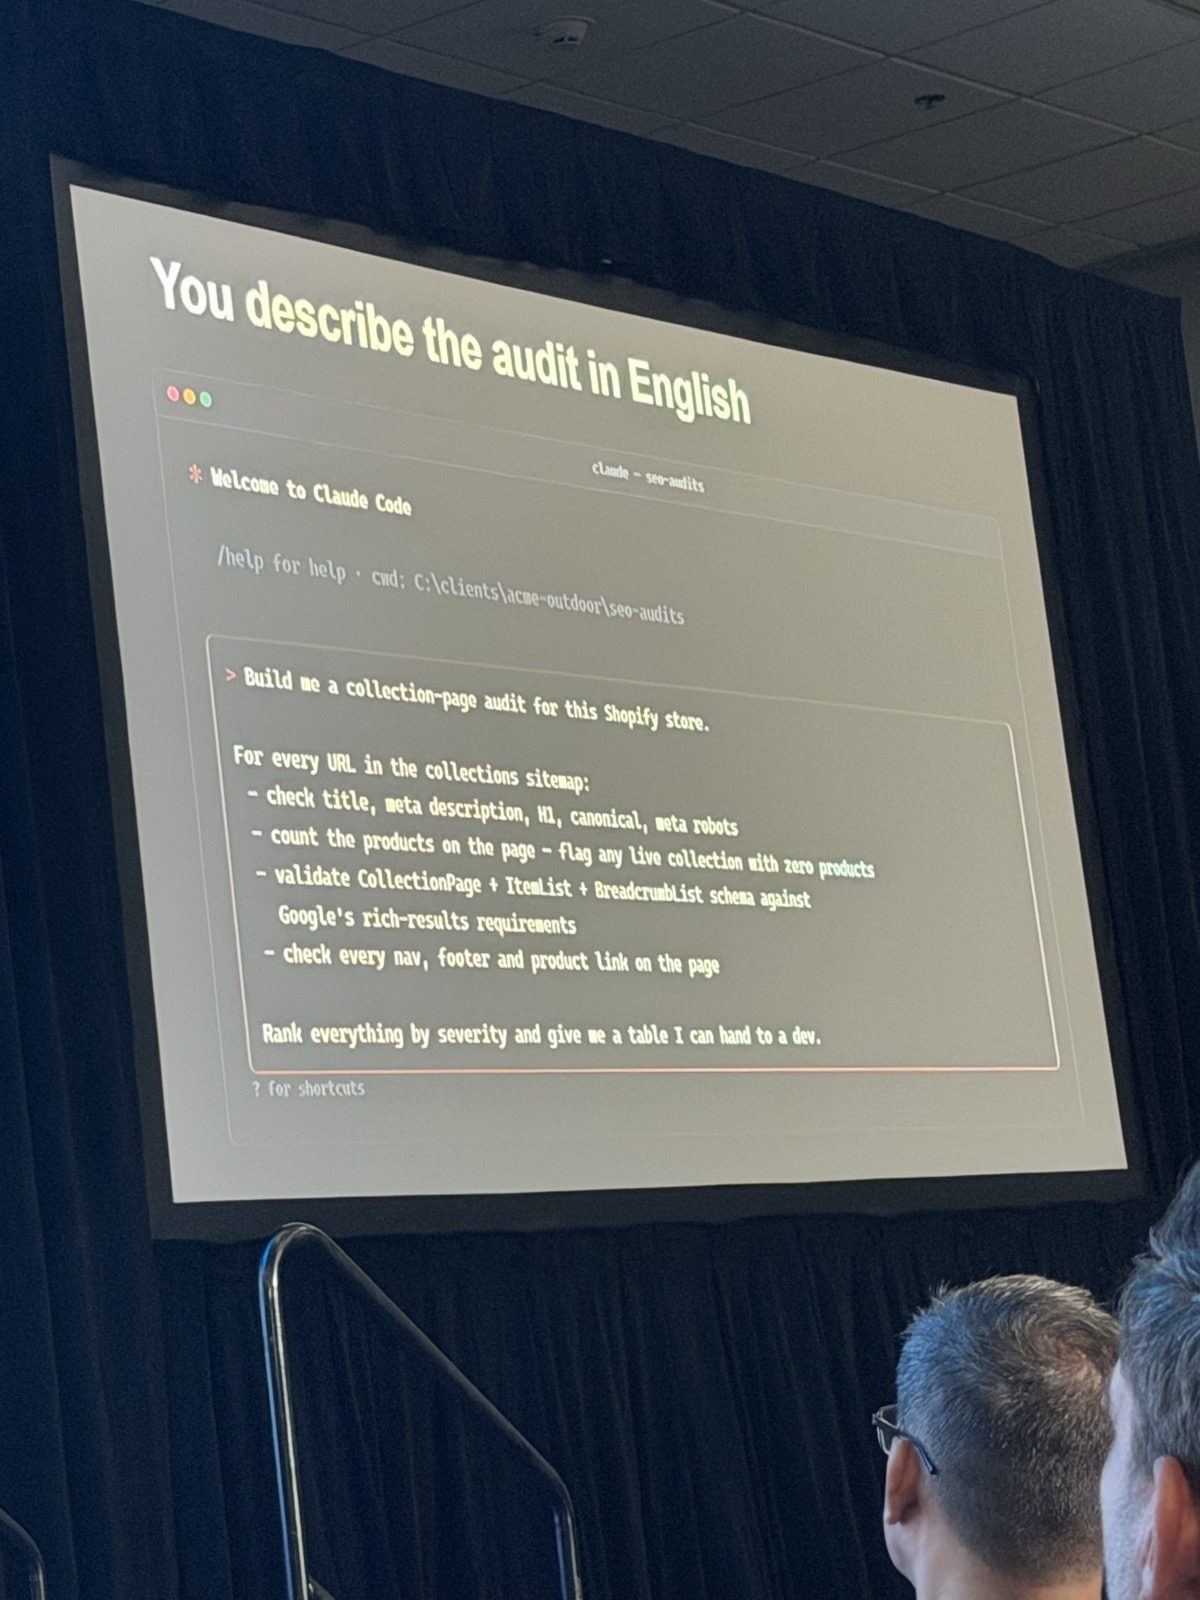
Caiozzo corta en otro punto. Su prompt de ejemplo termina en “Rank everything by severity and give me a table I can hand to a dev.” El agente detecta y ordena; la persona decide qué se arregla. Y el criterio lo escribe él antes de que corra nada: un archivo de configuración por cliente con mercados, keywords de marca, sitemaps y umbrales, como la cantidad mínima de productos que tiene que tener una categoría. El hallazgo que mostró fue una página con 2.100 clicks y cero productos. Ese check existe porque alguien decidió que una categoría vacía con tráfico es un problema. El agente lo corre todas las semanas.
El deck de Writesonic lo resumió en tres palabras al hablar de agentes que corren sin supervisión: “volume without judgment”.
| Qué hace el agente | Dónde para | Quién revisa | |
|---|---|---|---|
| Audit de John Caiozzo | Crawl de muestra o completo, checks, cruce con Search Console, entregable | En una tabla priorizada por severidad | El SEO define checks y umbrales; el dev arregla |
| Workflow de Mike Korenugin | Elige piezas, arma research, escribe el borrador, vuelve a medir a ~8 semanas | Antes de publicar | Un segundo agente de QA y una persona que aprueba y publica |
| Nuestro motor de notas para Discover | Research, redacción, controles de fidelidad y coherencia | En un borrador con su bloque de QA | Dos controles automáticos; el redactor elige el ángulo antes y publica después |
¿Qué pasa cuando el que revisa también es un agente?
Esto no lo vi en ninguna de las charlas. El segundo agente de QA arregla el problema del borrador malo, pero trae otro: un control que da verde sin haber controlado nada. Lo vivimos en dos pipelines propios.
El motor de notas para Discover. Lo armamos para el equipo que produce contenido para clientes de medios: propone ángulos, investiga, escribe y entrega un borrador. Tiene dos controles en serie. Uno de fidelidad (cada dato de la nota tiene que estar en el material de fuente) y otro de coherencia (país, jurisdicción, fecha). El segundo existe porque el primero no alcanzó: en una nota argentina que citaba a la Suprema Corte de México, el de fidelidad había dado verde. El dato estaba en la fuente, pero la fuente era de otro país.
Después vino el error más caro. El responsable de producto de contenidos que lo testeaba reportó el mismo fallo en 4 de 4 corridas: notas con veredicto verde que no servían. La causa: el modelo a veces contestaba en texto libre en vez del formato que el control esperaba. El control no podía leer su propia respuesta, la tomaba como vacía, y vacía quería decir cero afirmaciones para verificar. Cero afirmaciones, cero errores: verde. Mis tres primeras rondas de arreglos sumaron avisos y logs, pero el comportamiento era el mismo, y él tenía razón en decir que seguía fallando. El arreglo de verdad fue cambiar la regla: si el control no puede leer su resultado, la nota sale en rojo.
En el mismo motor, si la llamada al modelo fallaba dos veces, el sistema pasaba en silencio a gpt-4o-mini. Es el modelo que habíamos sacado de los controles porque aprobaba afirmaciones vagas, y el que en redacción daba 84% de texto detectado como IA (QuillBot) contra 0% con Claude. Lo encontraron dos agentes verificadores independientes. Ahora, si el modelo cambia, queda escrito en el bloque de QA que lee el redactor.
El pipeline de contenido de un cliente B2B de staffing. El cliente leyó una nota publicada y el formato estaba mal. Auditamos lo entregado: 43 de 43 piezas tenían cero listas y una mediana de 5 tablas por pieza. El ensamblador no tenía bloque de lista, y el QA medía palabras, H2, tablas, links, anchors, FAQ y similitud con el brief, pero no listas ni párrafos largos. Pasaron las 43 sin una alarma. En el mismo pipeline, el control de alineación guardaba un coseno de 0,49 contra un umbral documentado de 0,60 y devolvía “pass” igual: calculaba la métrica y el veredicto no la usaba.
Un control que calcula una métrica y no la usa es peor que no tener control, porque hace creer que hay uno.
¿Quién tiene que revisar, entonces?
Las reglas que dejamos escritas después de esos errores, más una que tomo de Korenugin:
- El que verifica no es el que produjo. Corre como agente sin el contexto de producción y chequea contra los archivos y las fuentes, no contra lo que el productor dice haber hecho.
- El control falla en rojo. Si no puede leer su resultado, si el modelo cambió o si falta material, el veredicto no puede ser verde.
- Primero se audita el instrumento. Antes de mirar los entregables, preguntarse si el QA mide la dimensión donde puede estar el defecto. Si no la mide, que no haya alarmas no dice nada.
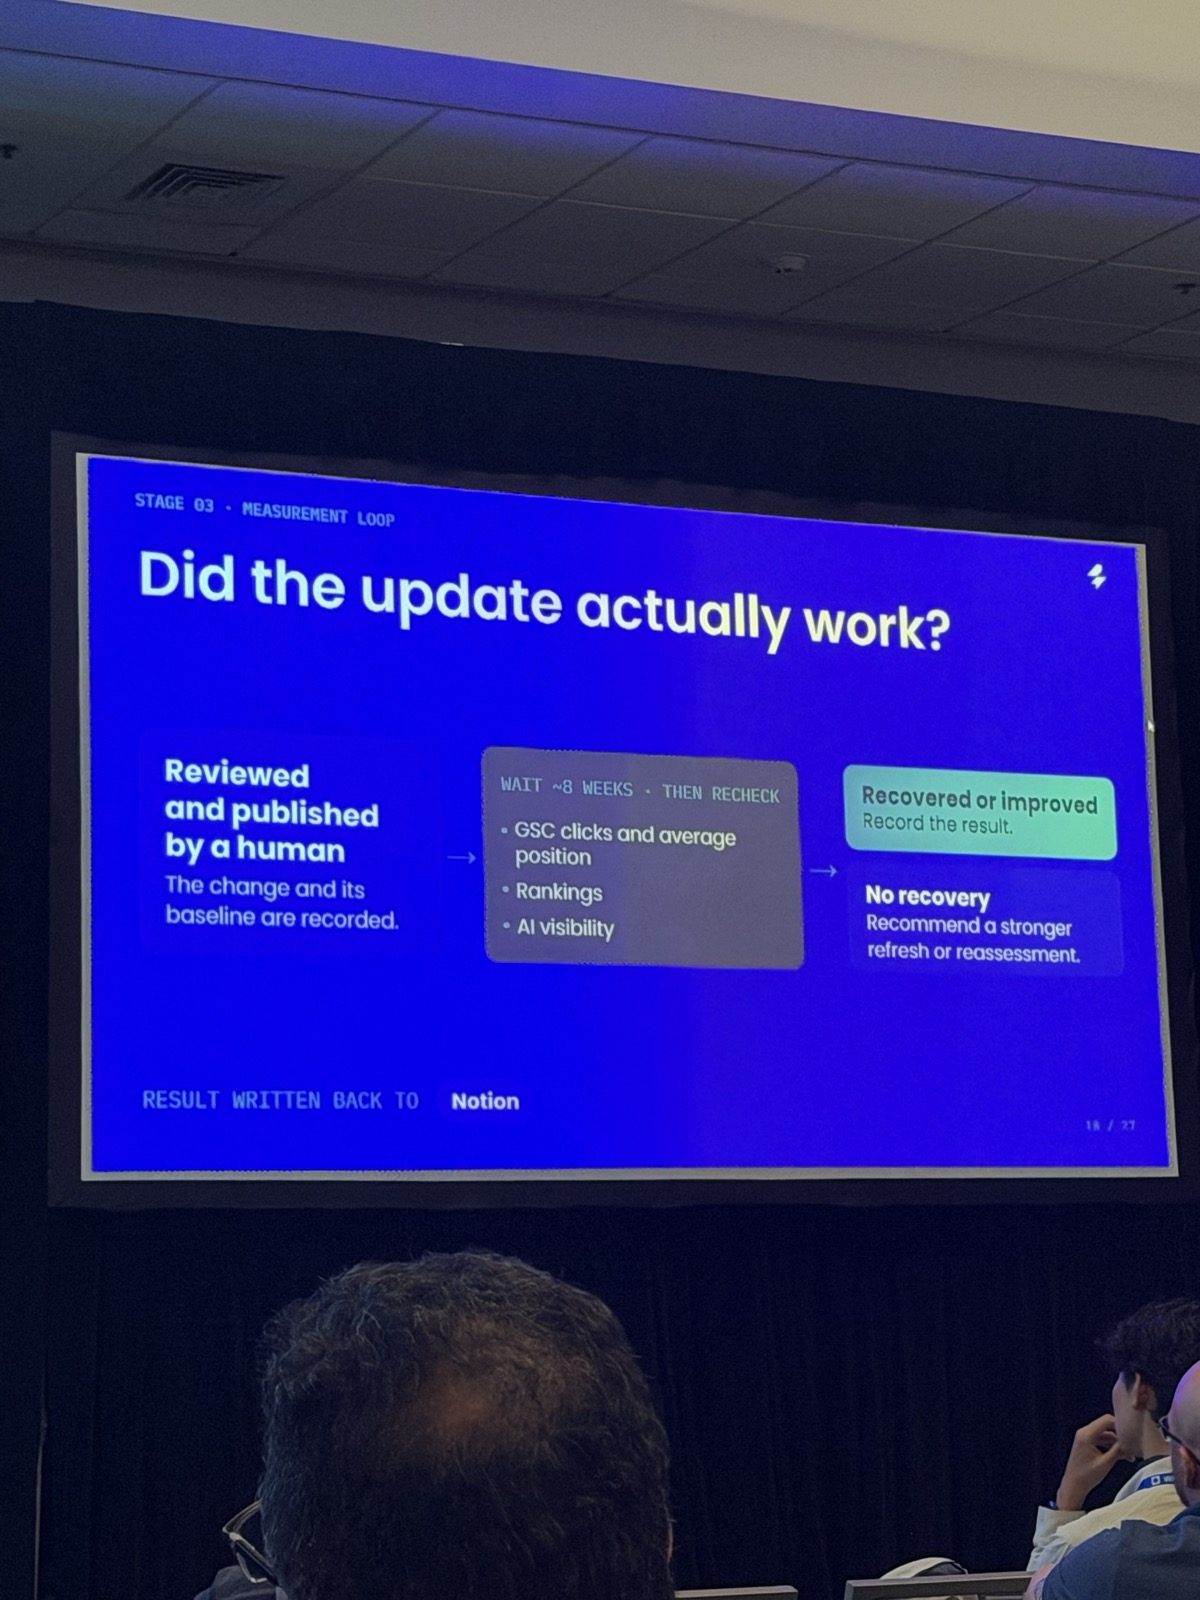
- La revisión sigue después de publicar. Es la parte que Korenugin tiene automatizada: a las ~8 semanas el agente vuelve a mirar clics y posición en Search Console, rankings y visibilidad en IA, y si la pieza no recuperó, recomienda una intervención más fuerte.
Dónde para el agente también depende del tipo de decisión. Caiozzo audita una muestra de 5 a 10 páginas por tipo y lo dice en la slide: es la puerta al audit completo, no el audit. Para detectar errores que se repiten todas las semanas, una muestra que corre sola sirve. Para decidir la arquitectura de URLs, en la agencia tenemos escrita la regla contraria: se audita el universo completo de queries, porque una muestra chica nos llevó a una conclusión que el universo completo desmintió. Mi lectura: cuanto más difícil de deshacer es la decisión, antes tiene que parar el agente.
¿Es un tema de herramientas o de producto?
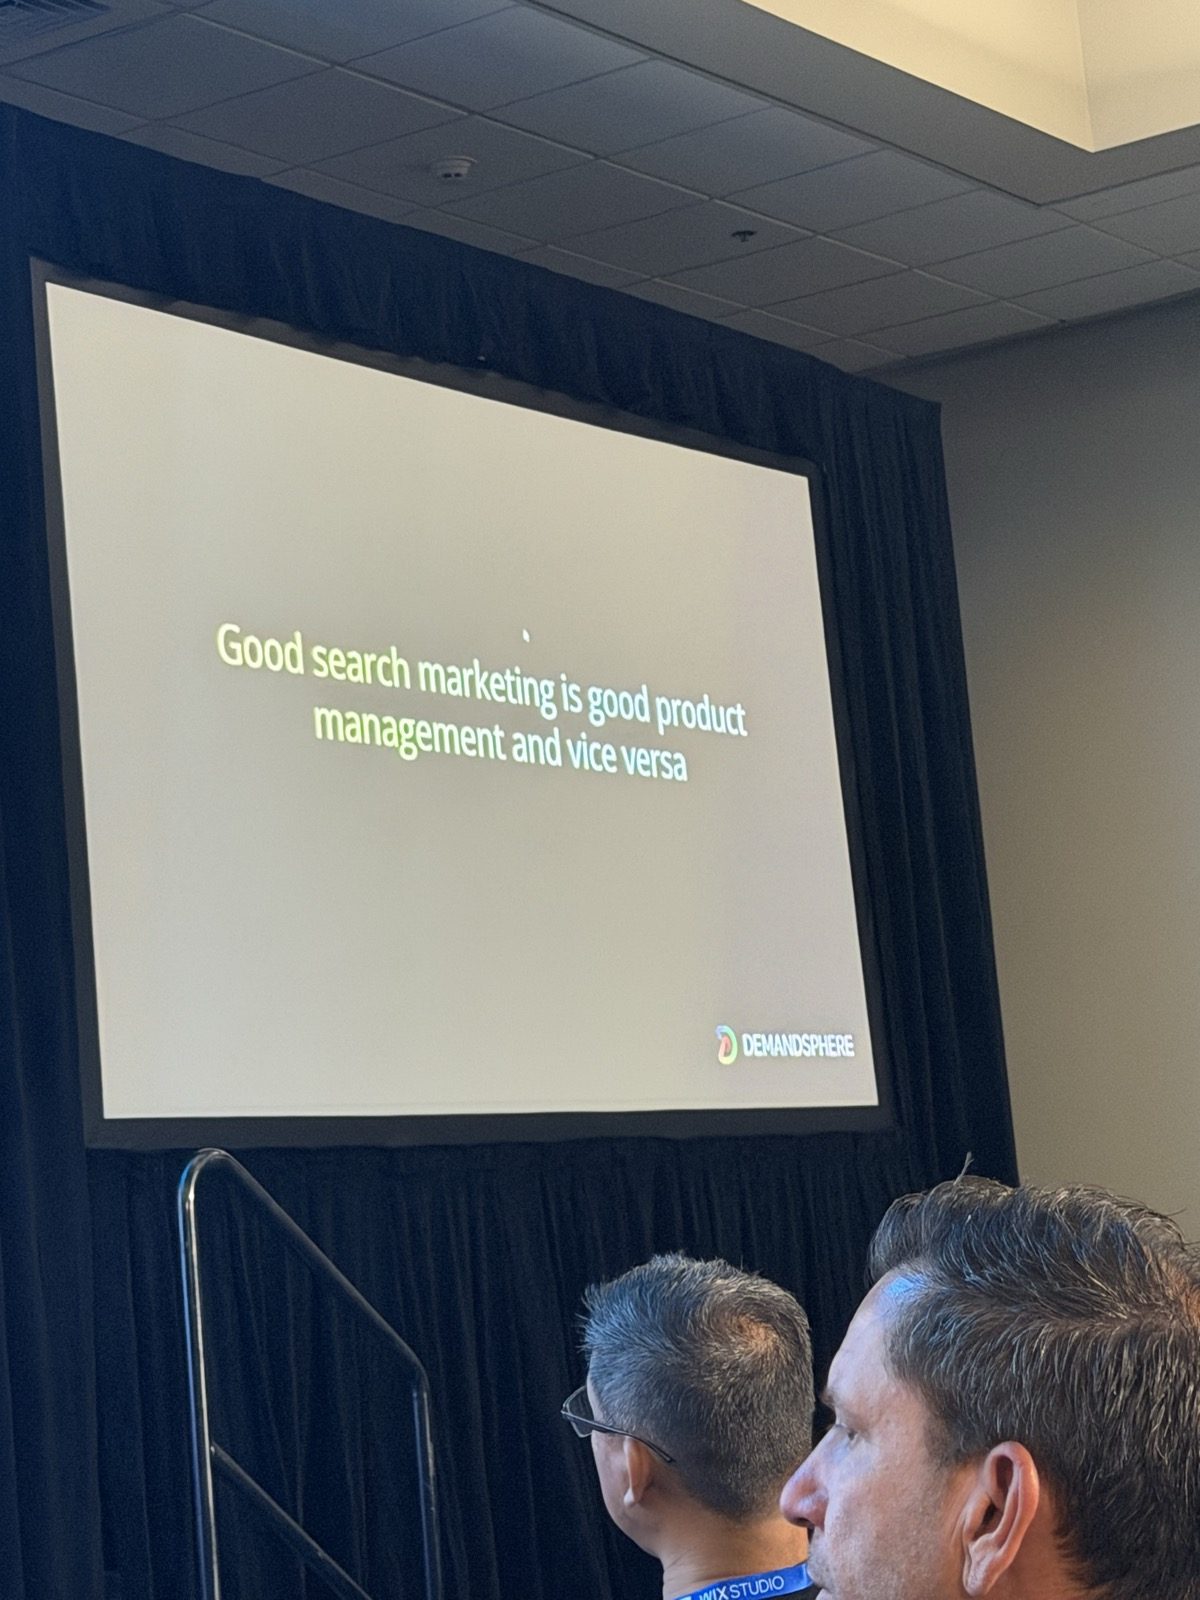
Ray Grieselhuber (DemandSphere) dio “Data Strategy & Engineering for Agentic Workflows”. De su charla no tengo grabación, solo dos slides. Dicen: “Good search marketing is good product management and vice versa” y “Agentic engineering enables the ability to improve both”. No sé cómo lo desarrolló, así que no le atribuyo más que eso.
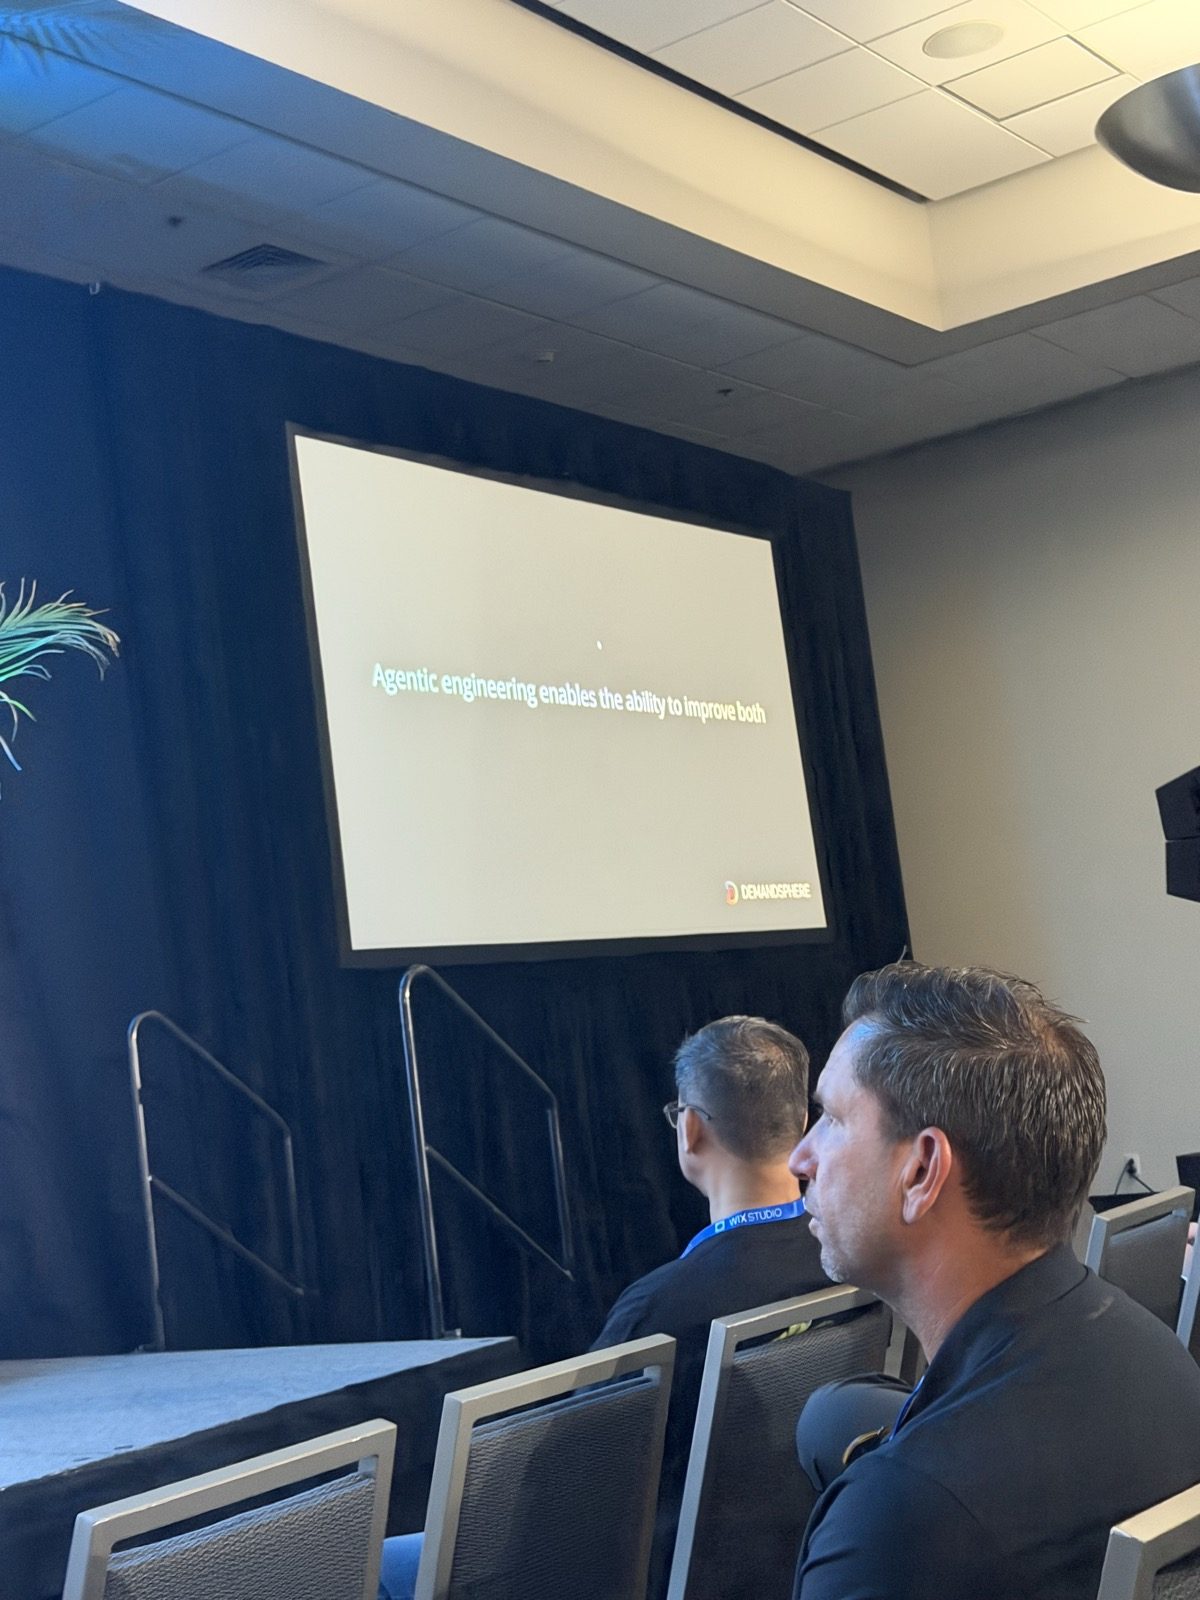
Lo que sí leo yo, desde lo que nos pasó: decidir qué hace el agente, dónde para y quién revisa es una decisión de producto, igual que decidir qué hace una funcionalidad y qué no. El modelo y la herramienta se cambian. Lo que hay que diseñar es el corte.
¿Qué límites tienen estos datos?
- Los números de Korenugin son del sitio de su propia empresa, que vende una herramienta de visibilidad en IA. El citation share del cluster objetivo pasó de 1% a 3,4% en ChatGPT y de 3,8% a 5,3% en AI Overviews en 30 días, y él mismo aclaró que no fue solo ese trabajo.
- Los tiempos de Caiozzo son de su propio proceso, antes y después. La página con 2.100 clicks y cero productos es un ejemplo: no dijo con qué frecuencia aparece.
- Nuestros dos casos son de pipelines de contenido, con pocas corridas (las 4 de 4 son las que reportó quien lo testeaba). Muestran cómo falla un control, no cuánto rinde un agente.
Un agente te da más volumen el día que lo prendés. El criterio hay que escribirlo antes: qué chequea, con qué umbral, dónde para y qué hace cuando el control falla. ¿Ustedes dónde pusieron el corte?
Serie brightonSEO San Diego 2026
- ¿Cómo medir el impacto de la IA en tu negocio? En leads y marca, no en el tráfico de ChatGPT
- ¿Qué fuentes cita la IA cuando habla de tu marca? Depende del rubro y del motor
- ¿Por qué una página lenta queda afuera de las respuestas de IA? SEO técnico para bots, con logs
- ¿Qué página cita la IA? La que responde arriba y respalda lo que afirma
- Agentes de IA en SEO: ¿dónde tiene que parar la automatización? (este artículo)
- ¿El volumen de búsqueda mide la demanda? Dónde está la demanda real
- Autoridad offsite en IA: ¿dónde tiene que estar tu marca cuando el motor arma la respuesta?
- ¿Cómo le habla el SEO a dirección ahora que la IA le abrió la puerta?
Toda la serie en un solo lugar: brightonSEO 2026.