Publicado en nicolasbillia.com — Octubre 2026 · Serie brightonSEO San Diego 2026
Disclaimer
Este contenido fue escrito con ayuda de IA a partir de mis desgrabaciones y fotos de las charlas de brightonSEO + Hero Conf San Diego (15 y 16 de septiembre de 2026) y de datos de proyectos de Nomadic. Los datos del evento llevan el nombre de quien los presentó; los de clientes van sin nombre y por rubro. Las fotos de las slides son mías.
En corto
- Para un motor de IA, una página lenta no baja posiciones: queda afuera de los candidatos a cita.
- En un análisis de ~700.000 páginas, las que daban timeout seguido a los crawlers de IA tuvieron 18 veces menos citaciones (Zach Chahalis, iPullRank).
- ChatGPT y Perplexity no renderizan JavaScript. Lo que aparece recién con JS no existe para ellos.
- Bloquear “todo lo de OpenAI” para frenar el entrenamiento te saca de ChatGPT Search. El bot de entrenamiento es GPTBot.
- Nada de esto se ve en Search Console. Se ve en los logs del servidor o del CDN.
¿Qué le pasa a una página lenta cuando la pide un bot de IA?
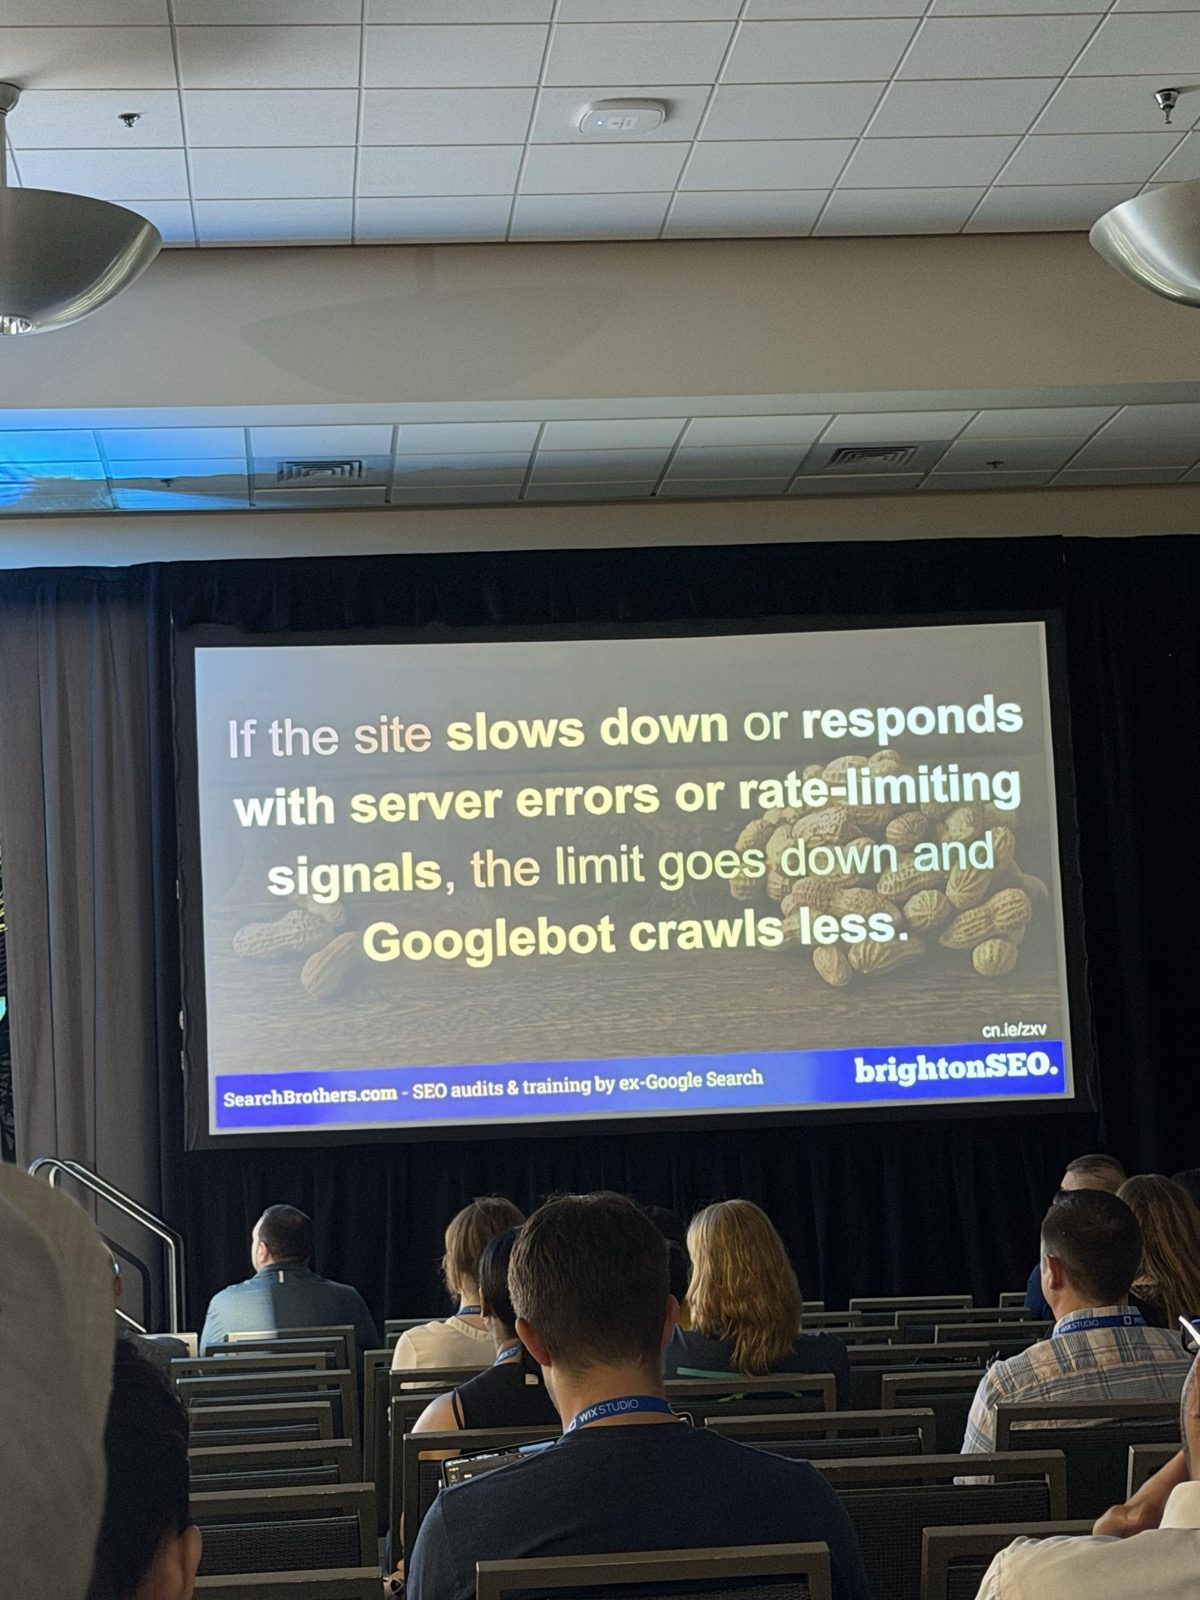
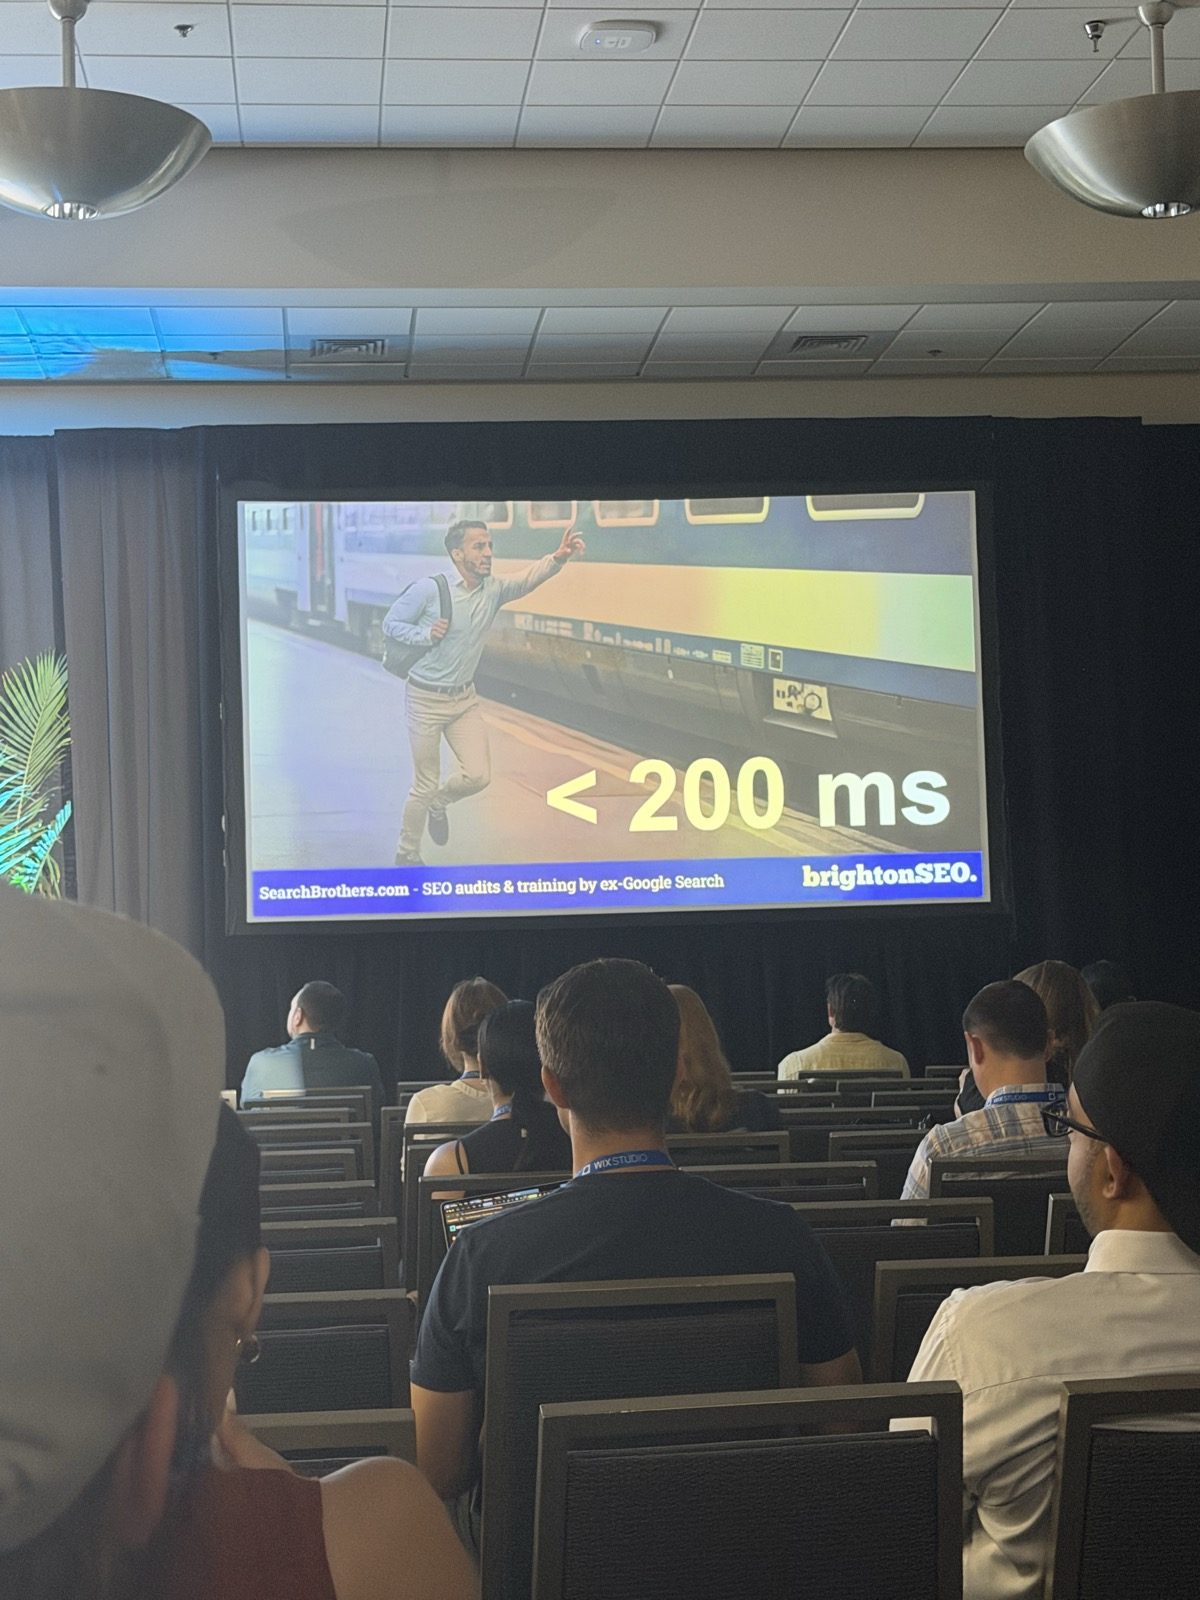
Con Google, la lentitud se paga en frecuencia de rastreo. Fili Wiese lo mostró en “HTTP Responses for SEO: Making Googlebot Crawl Smarter, Not Harder”, con casos de clientes sin identificar: si el sitio se pone lento o responde con errores, Google baja el límite y rastrea menos, y recuperar esa confianza lleva tiempo. El objetivo de respuesta del servidor que propone es menos de 200 ms.
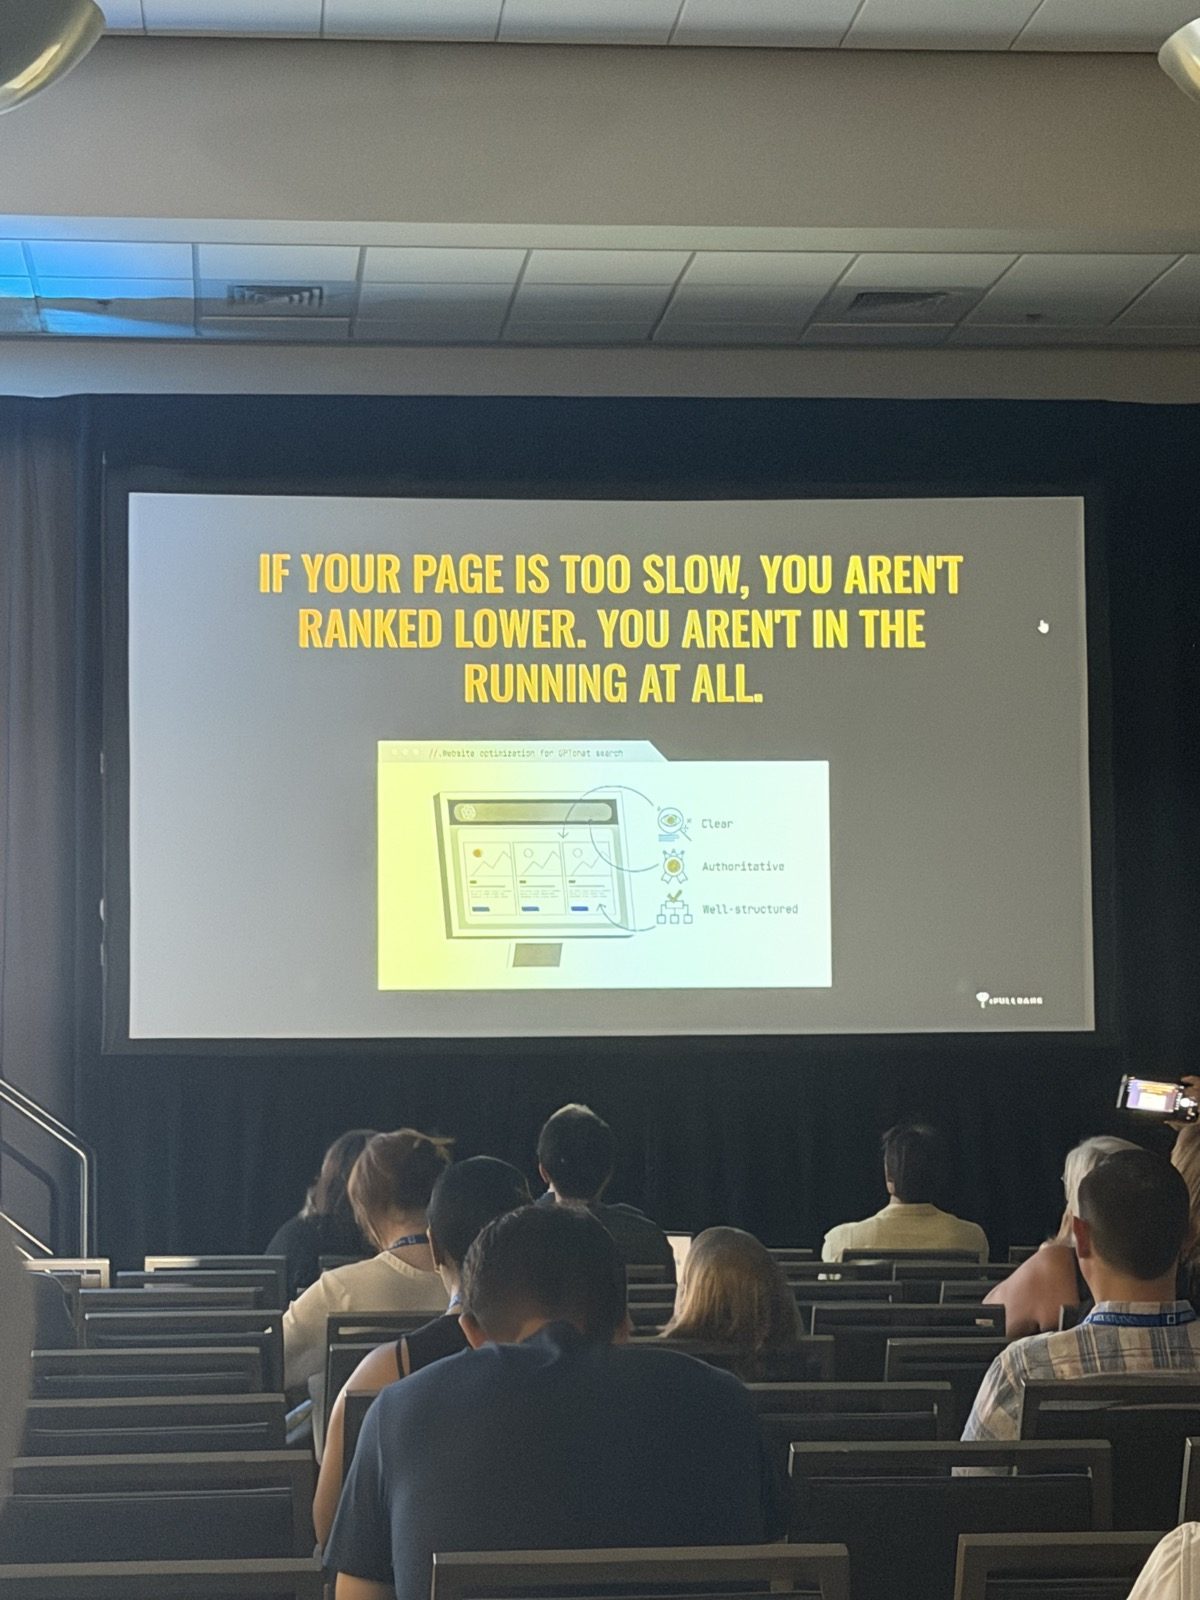
Con los bots de IA el castigo es otro. Zach Chahalis, de iPullRank, lo puso así en “Log File Forensics: How To Analyze Log Files For AI Search”: si tu página es demasiado lenta, no rankeás más abajo; directamente no estás en la carrera.
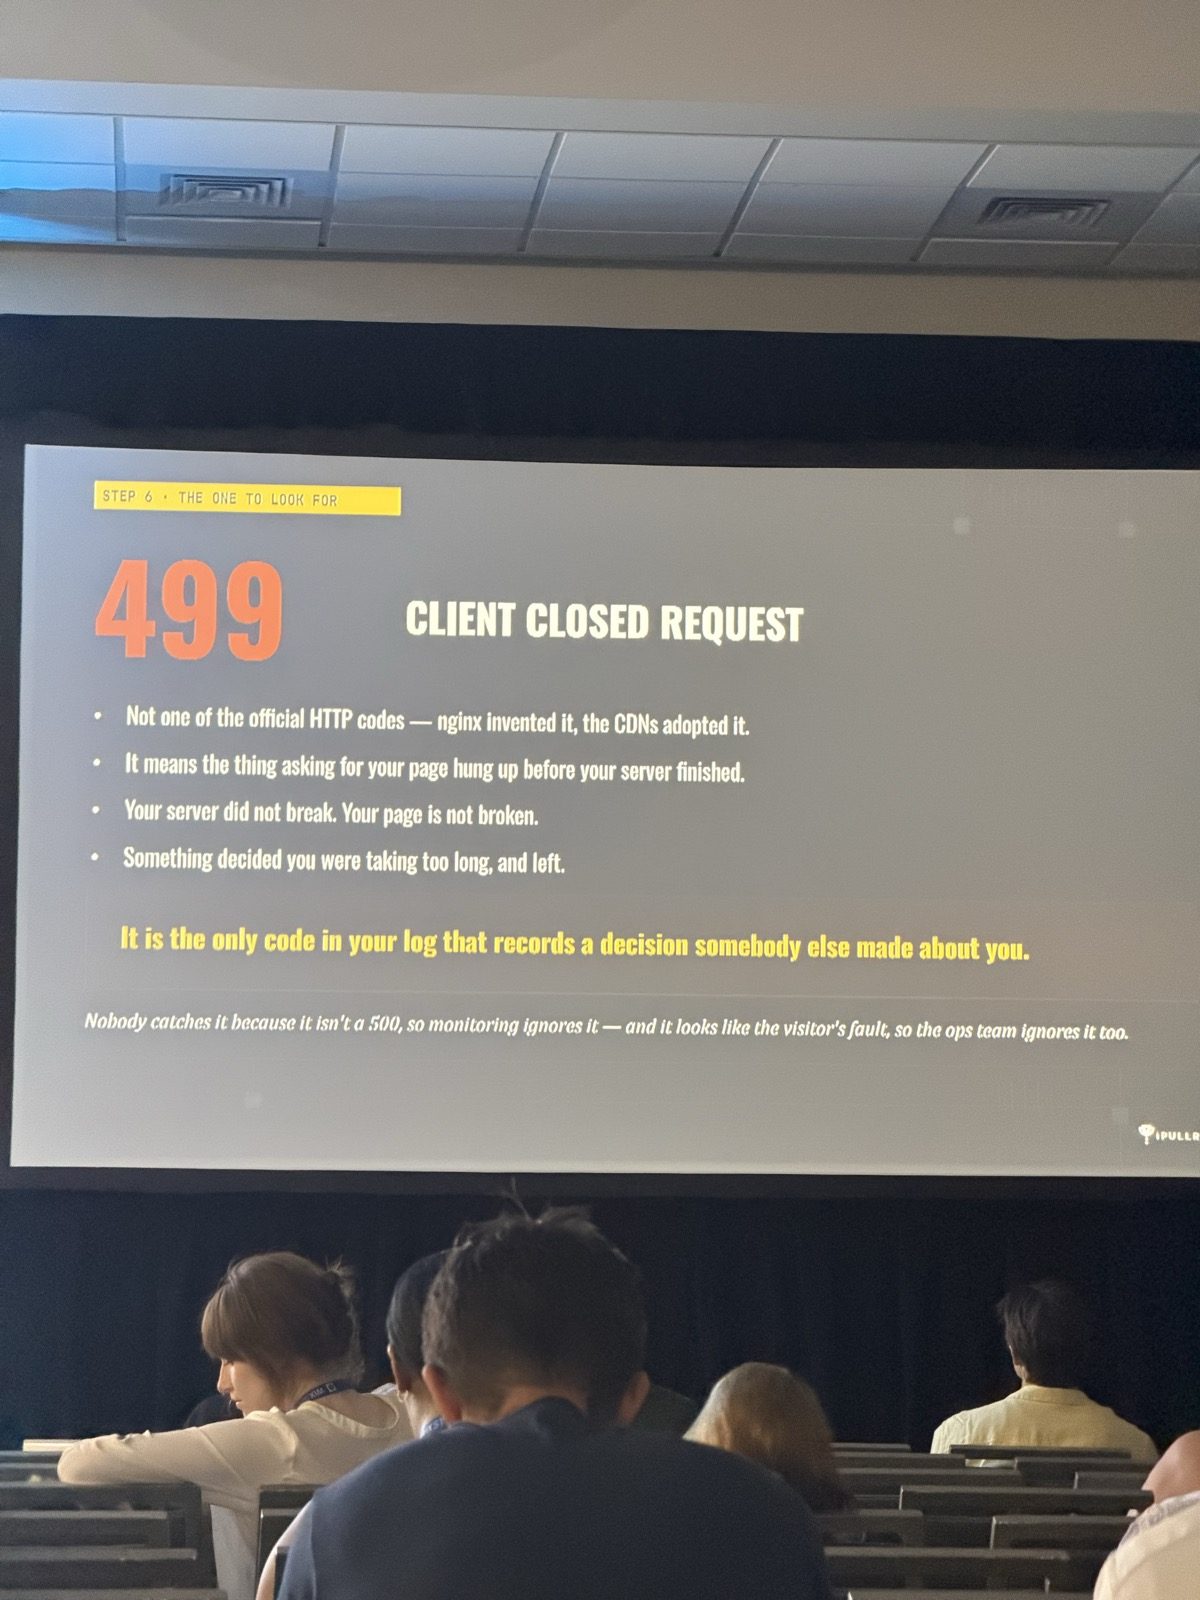
La señal que lo registra es el código 499, “client closed request”. No es un código HTTP oficial: lo inventó nginx y lo adoptaron los CDN. Significa que el que pedía la página cortó antes de que el servidor terminara: decidió que tardabas demasiado y se fue. Como no es un 500, el monitoreo no lo levanta, y como parece culpa del visitante, el equipo de operaciones tampoco.
Chahalis sumó una diferencia con Google: ante un error de servidor, los bots de IA no suelen volver a intentar. “Google es un poco más tolerante; los bots de IA, no.” Trajo un cliente al que, tras un cambio de código, ninguna página le cargaba en menos de unos 6 segundos: subieron los 499 de todos los bots de IA y cayeron las citaciones. Revirtieron y volvieron en cinco o seis días. Y un análisis conjunto con Profound:
| Qué midieron | Resultado | Muestra |
|---|---|---|
| Páginas que daban timeout seguido cuando un crawler de IA las pedía | 18 veces menos citaciones | ~700.000 páginas |
| Páginas que fallaban más de tres cuartas partes de las veces | 0 citaciones en muchos casos | Mismo dataset |
| Efecto de corregir solo los 499 | +22% de visibilidad en IA | El partner del piloto |
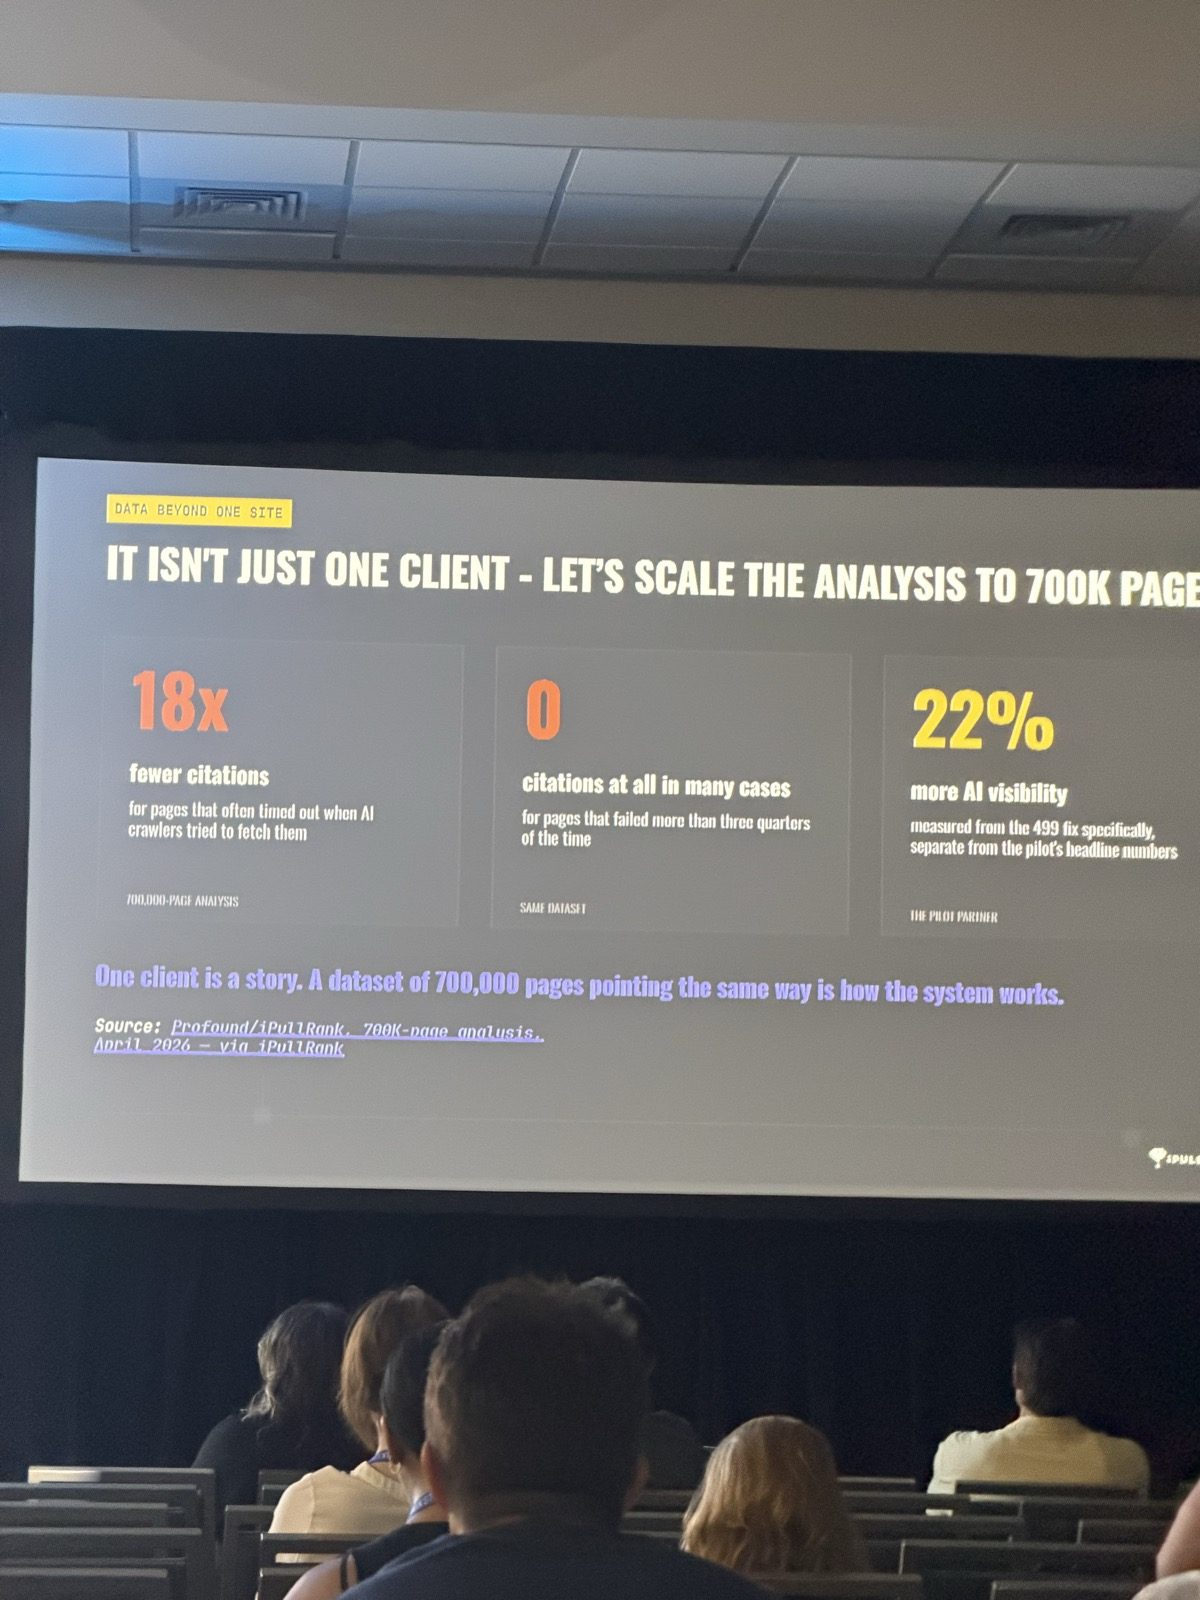
Aclaración para que no se lea mal: es un estudio de dos proveedores (abril de 2026), sin grupo de control mostrado en la charla. Prueba que timeout y falta de citación van juntos, no cuánto pesa uno sobre otro. El +22% sale de un solo partner y el caso de los 6 segundos es un cliente.
¿Qué tan lento es lento? Lo que mostraron los logs de una OTA
En agosto analizamos los logs de nginx de una OTA de LATAM en tres mercados. En el log aparecían tres bots de OpenAI, con 459.730 pedidos por día entre los tres. Tiempo medio de respuesta que recibían, del 21 al 27 de agosto:
| Plantilla | Tiempo medio para los bots de OpenAI |
|---|---|
| Ruta de vuelos origen-destino | 2.685 a 3.107 ms |
| Ficha de hotel | 373 a 658 ms |
| Referencia: el objetivo que plantea Fili Wiese | menos de 200 ms |
ChatGPT-User, el bot que sale a buscar una página cuando una persona le pregunta algo a ChatGPT, dedicaba entre 59% y 66% de sus pedidos a vuelos, la plantilla más lenta. GPTBot, el que junta texto para entrenar, pedía entre 91% y 99,8% fichas de hotel, la rápida. El bot que tiene a alguien esperando del otro lado iba a las páginas que tardan más de 13 veces el objetivo de Fili.
Un error que casi cometimos: con el promedio por bot, el servidor parecía responderle 5 a 7 veces más lento a ChatGPT-User que a GPTBot. Sobre las mismas URLs, el mismo día y con el mismo código, la relación daba 0,65 a 1,01: la diferencia era qué páginas pedía cada uno. Leer el log sin controlar el mix de URLs es otra forma de suponer.
La acción salió del mismo log. La cache de vuelos ya existía y duraba 5 minutos: la misma URL pasaba de 3.102 a 328 ms. El pedido fue extender esa ventana, y alcanza a los bots de IA sin hacer nada aparte. Es la primera fila de la tabla de Chahalis que está más abajo.
Lo que no medimos: cuántos pedidos se cortaron. El tiempo medio es sobre respuestas entregadas y el log era del servidor de origen, no del CDN, que es la fuente que Chahalis pone primera. Tampoco conectamos esa latencia con las citaciones del sitio.
¿Y si el bot entra rápido pero no puede leer la página?
John Caiozzo lo dijo en “4 Hours to 30 Minutes: Automating High-Impact SEO Audits With Claude Code”: ChatGPT no renderiza JavaScript, Perplexity tampoco. Googlebot sí, en una segunda pasada.
Amanda Kopen contó en “AEO in 2026: What’s Actually Working Now” lo que le pasó a HubSpot: ChatGPT mostraba precios desactualizados y, al auditar, encontraron que las páginas de pricing, cargadas de JavaScript, eran ilegibles para los crawlers de IA: “se quedaban un rato, adivinaban y se iban”. Publicaron versiones sin JavaScript y todos los productos menos uno mejoraron su puntaje de exactitud, medido con prompts en su herramienta de AEO y seguido semana a semana.
En una preventa con una empresa de staffing de ingenieros leímos cada página dos veces: una como GPTBot, sin ejecutar JavaScript, y otra con navegador. En el blog llegaba al bot el 99,3% del texto; en las landings, el 88,5%. Pero las 11 URLs de la plantilla de recursos, donde vivían los casos de éxito, devolvían 0 palabras y ningún H1, y una respondía 404 al bot mientras al usuario le mostraba contenido. Decir “el sitio no renderiza” habría sido falso: el problema era una plantilla.
¿Cómo sé si estoy bloqueando al bot equivocado?
Chahalis separa los bots de IA en cuatro tipos: entrenamiento, indexación, pedido en vivo y acción. El error frecuente es querer frenar el entrenamiento y bloquear todo lo que diga OpenAI. Su frase: “Listo, te sacaste de ChatGPT Search”. El que arma ese índice es OAI-SearchBot; el de entrenamiento es GPTBot.
Así se veían los tres bots de OpenAI en el log de la OTA:
| Bot | Para qué es | Qué vimos en el log |
|---|---|---|
| GPTBot | Entrenamiento | Dejó de rastrear dos de los tres mercados entre el 28 y el 31 de julio (−99,5%), sin que nadie lo bloqueara |
| OAI-SearchBot | Índice de ChatGPT Search | 91,1% de sus pedidos no aportaba página nueva: copias con parámetros y redirecciones |
| ChatGPT-User | Pedido en vivo | El único que ignoraba el robots.txt (1,4% de sus pedidos a rutas bloqueadas en un mercado) |
Elegir el bot es la mitad; la otra es cómo se escribe el robots.txt. A un retailer de moda le entregamos un robots con un bloque User-agent: Googlebot que repetía las 38 reglas Disallow del bloque *. En producción, el implementador lo dejó con dos Allow y el comentario “Solo reglas diferenciales respecto a *”: cero reglas de bloqueo para Google. El robots.txt no tiene herencia. Cada crawler aplica solo el grupo más específico que lo nombra y descarta el resto. En una de las dos marcas quedaron ~5.054 URLs con parámetros indexadas, el 53% de ese universo, que el equipo creía bloqueadas.
Con los bots de IA pasa lo mismo: si agregás un bloque User-agent: GPTBot, GPTBot deja de leer el bloque * entero.
Un contrapeso: Jen Cornwell (Tinuiti) mostró en “Why Your 2026 SEO Strategy Must Be a Cross-Functional OS” que Amazon bloquea cerca de 50 user agents y sigue siendo el ecommerce más citado, porque lo levantan de segunda mano desde blogs y publishers. Ese dato describe a Amazon; no lo trasladaría a un sitio del que casi nadie más escribe.
¿Qué le pido al equipo de desarrollo?
El pedido que propone Chahalis: primero una muestra, y recién validada, el volumen. Campos: IP, URL, fecha y hora, user agent, código de respuesta y bytes; si se puede, tiempo de respuesta y estado de cache. Mejor del CDN que del servidor, y de varias semanas. La identidad se verifica por IP, no por user agent: dice que cerca del 90% de los sitios que crawleó en seis meses lo dejaron pasar declarándose Googlebot (su práctica, sin muestra). Y preguntá qué user agents trae el archivo: el de la OTA venía filtrado a Googlebot y OpenAI, así que de Claude, Perplexity o Bingbot no podemos afirmar nada.
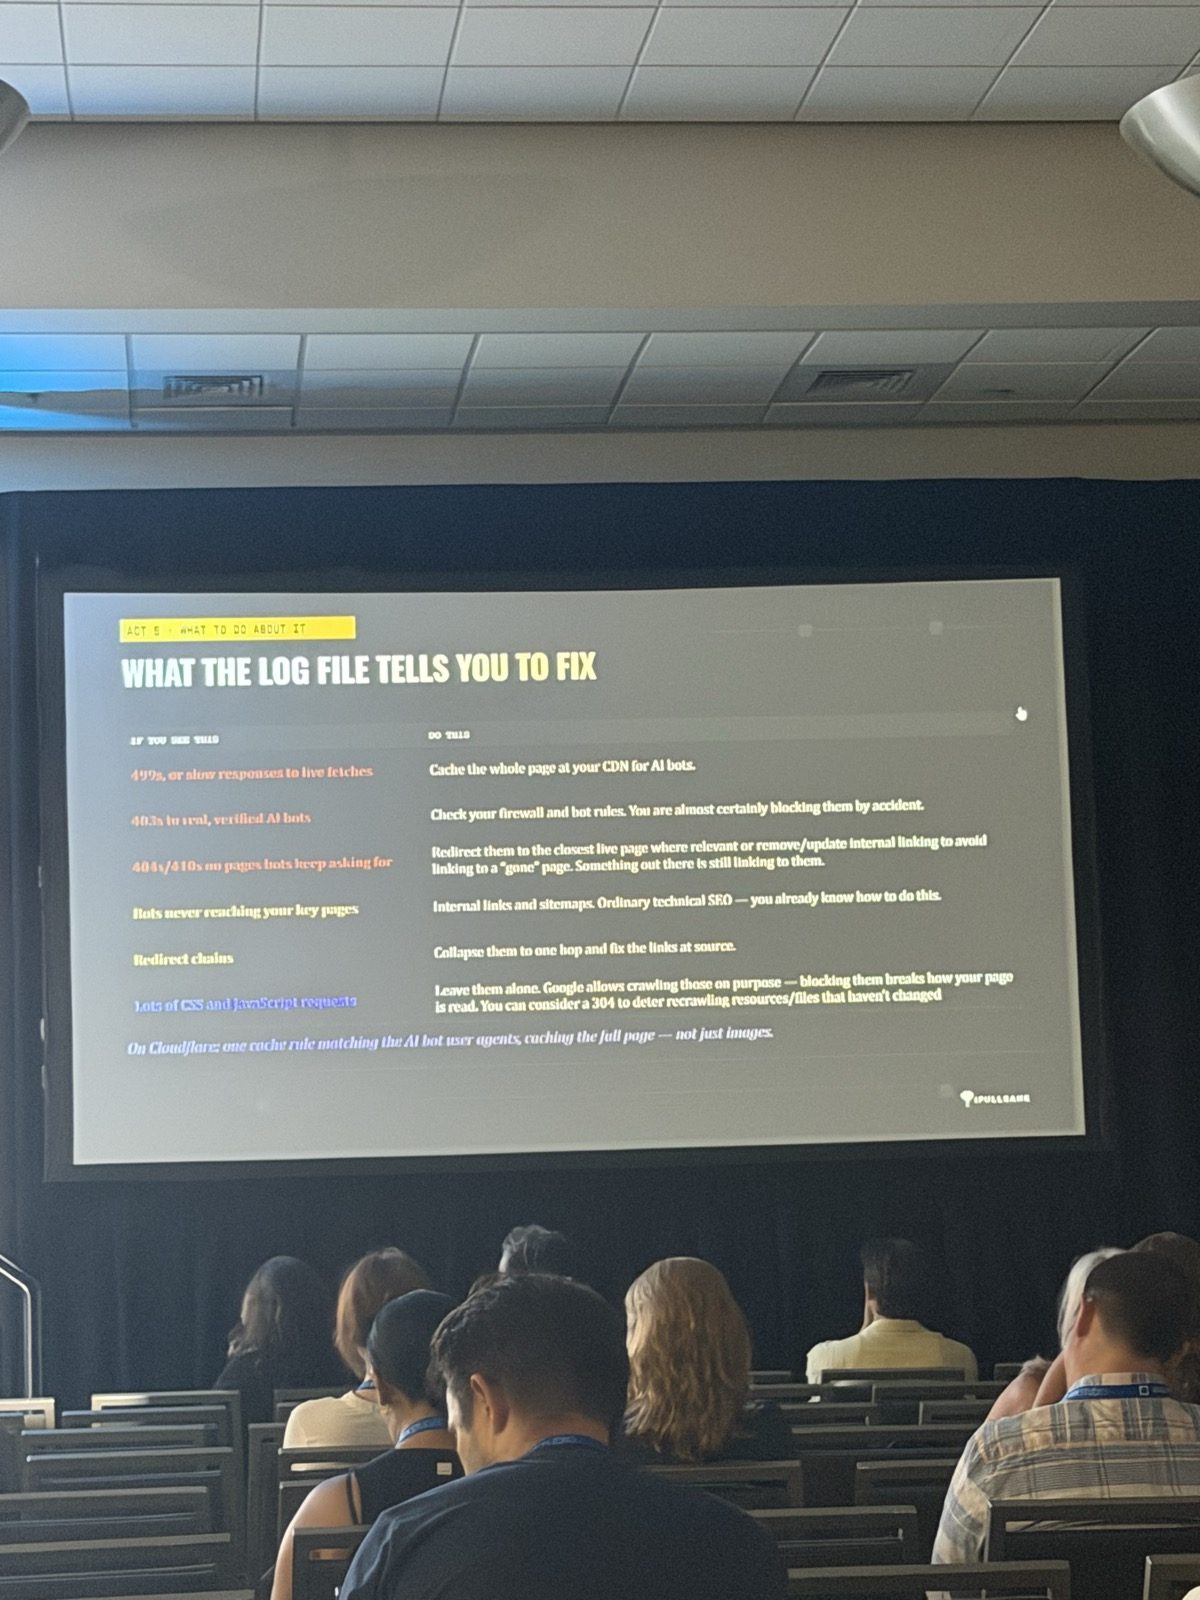
Con el log en la mano, tres preguntas: ¿entran?, ¿qué se llevan?, ¿esperan a que cargue? Y la tabla de Chahalis para pasar de lo que ves a lo que hacés:
| Si en el log ves | Hacé esto |
|---|---|
| 499 o respuestas lentas a pedidos en vivo | Cachear la página completa en el CDN para los bots de IA. En Cloudflare, una regla de cache que matchee sus user agents, no solo imágenes |
| 403 a bots de IA verificados | Revisar firewall y reglas de bots: casi seguro los estás bloqueando sin querer |
| 404 o 410 en páginas que los bots siguen pidiendo | Redirigir a la página viva más cercana o corregir los enlaces que apuntan ahí |
| Bots que nunca llegan a tus páginas importantes | Enlazado interno y sitemaps |
| Cadenas de redirección | Dejarlas en un salto y corregir el enlace de origen |
| Muchos pedidos de CSS y JavaScript | No bloquearlos; considerar un 304 para lo que no cambió |
¿Esto pesa lo suficiente frente a Google?
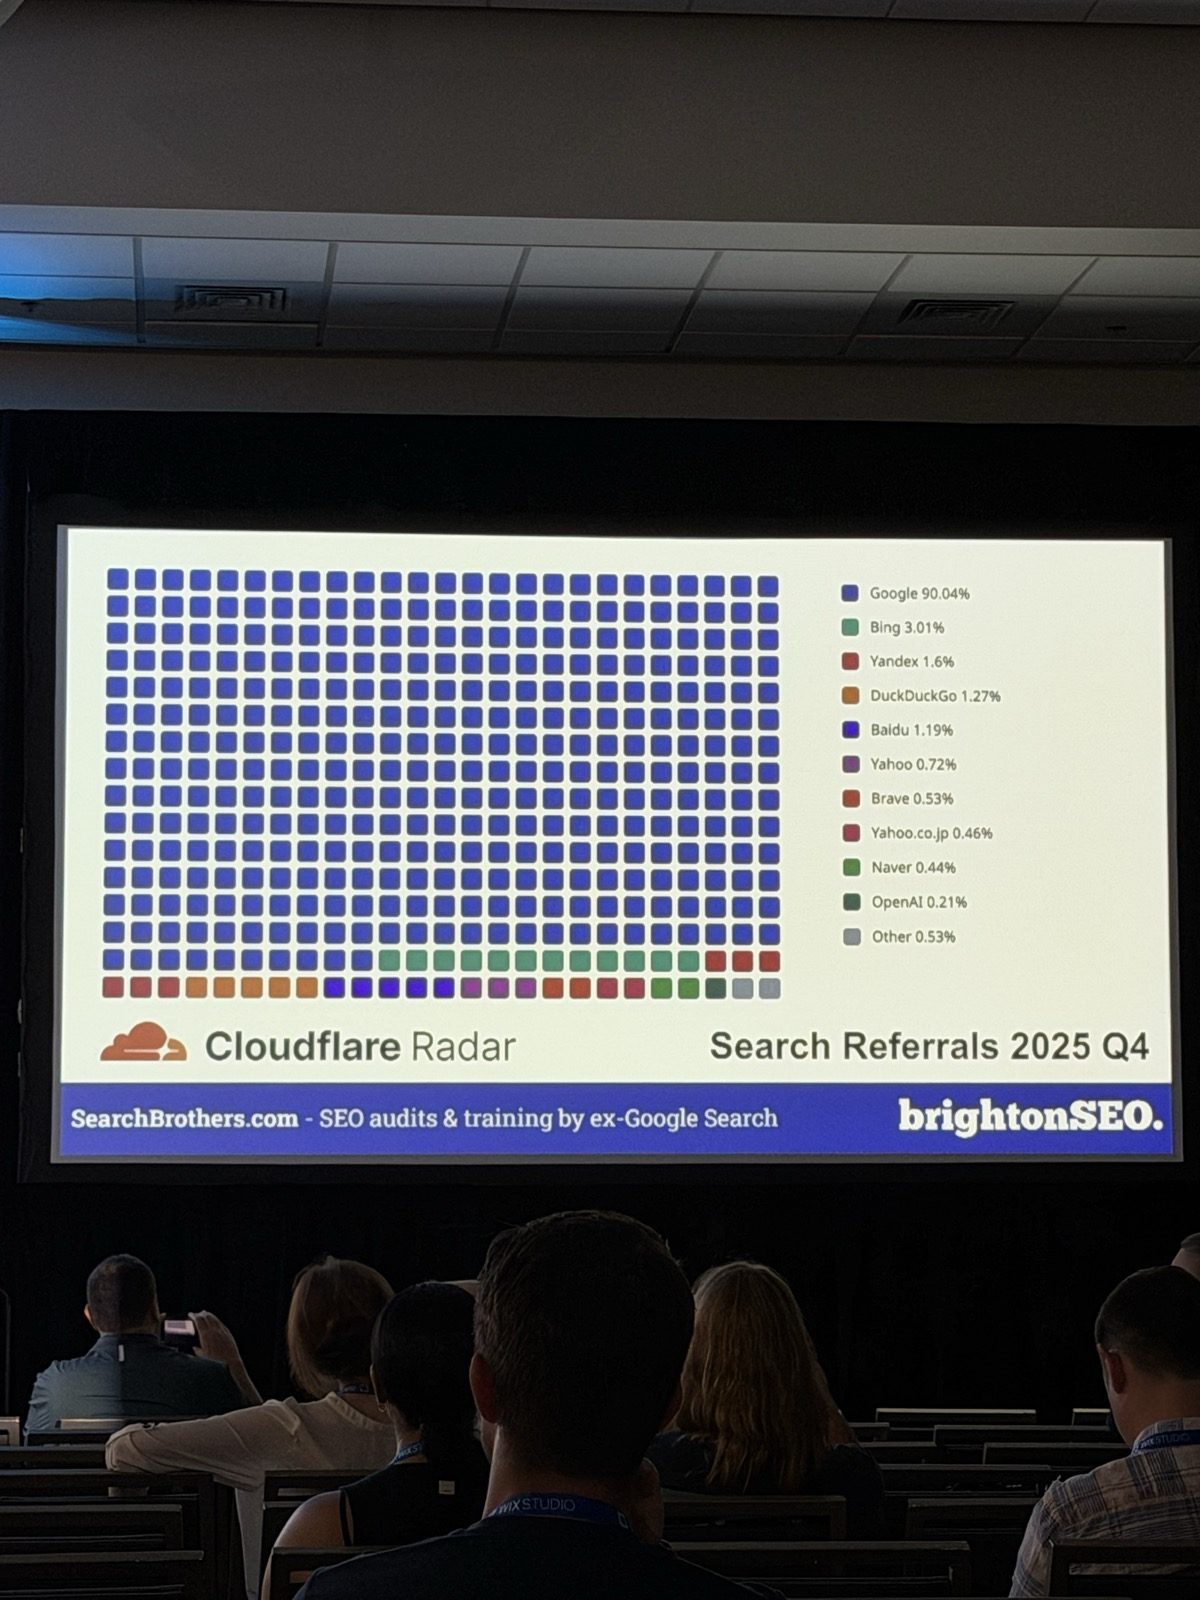
Según el Cloudflare Radar del cuarto trimestre de 2025 que mostró Fili Wiese, Google concentra el 90,04% de los referrals de búsqueda y OpenAI, el 0,21%. En la OTA, el tráfico que llegaba desde asistentes de IA era entre 0,05% y 0,35% de las visitas. No lo planteo como “dejá Google por la IA”: la cache, el contenido en el HTML inicial y un robots.txt bien escrito sirven a los dos. Lo que cambia es la consecuencia de no hacerlo. Google rastrea menos y tarda en recuperar la confianza; el bot de IA se va y, según Chahalis, no reintenta.
Para la IA, la página lenta o ilegible no está más abajo: no está. Y eso se ve en el log, no en Search Console. ¿Alguien ya está pidiendo logs del CDN para mirar los 499 de los bots de IA? Me interesa saber qué encontraron.
Serie brightonSEO San Diego 2026
- ¿Cómo medir el impacto de la IA en tu negocio? En leads y marca, no en el tráfico de ChatGPT
- ¿Qué fuentes cita la IA cuando habla de tu marca? Depende del rubro y del motor
- ¿Por qué una página lenta queda afuera de las respuestas de IA? SEO técnico para bots, con logs (este artículo)
- ¿Qué página cita la IA? La que responde arriba y respalda lo que afirma
- Agentes de IA en SEO: ¿dónde tiene que parar la automatización?
- ¿El volumen de búsqueda mide la demanda? Dónde está la demanda real
- Autoridad offsite en IA: ¿dónde tiene que estar tu marca cuando el motor arma la respuesta?
- ¿Cómo le habla el SEO a dirección ahora que la IA le abrió la puerta?
Toda la serie en un solo lugar: brightonSEO 2026.